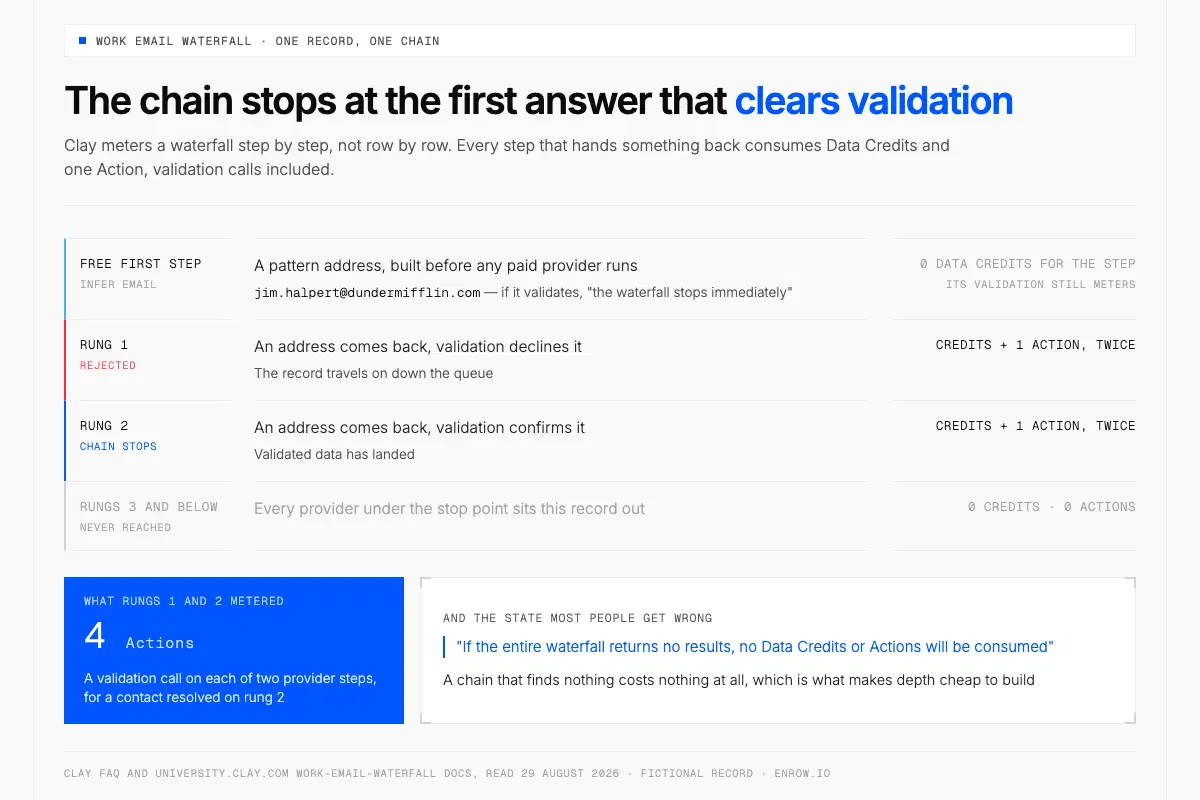
Abgerechnet wird je Schritt, nicht je Zeile, also zahlt ein Datensatz für jeden Schritt, der etwas liefert.
Das Wichtigste in Kürze Ein Wasserfall in Clay schaltet in einer Anreicherungsspalte mehrere Anbieter hintereinander und hält bei der ersten Antwort an, die deine Validierung besteht. Abgerechnet wird je Schritt, nicht je Zeile: „Each step of the waterfall that returns data will consume Data Credits (unless using API keys) and an Action“, Validierungsschritte mitgezählt. Bleibt die ganze Kette leer, gilt: „If the entire waterfall returns no results, no Data Credits or Actions will be consumed.“ Clays eigenes Rechenbeispiel über 100 Kontakte landet bei 95 Data Credits, zum Einstiegssatz sind das 4,75 $. Wie weit eine Kette läuft, regeln drei Einstellungen unter Full configuration: ein kostenloser Infer-Email-Schritt, der in Clays Test an Software-Firmen in rund 31 % der Fälle eine gültige Adresse liefert, vier Validierungsstrategien und ein Schwellenwert für Dubletten, der ab Werk auf 0 steht.
Angereichert wird in Clay immer spaltenweise. Du legst eine Spalte an, wählst einen Anbieter aus dem Verzeichnis, das die Preisseite mit „150+ providers“ beziffert, gibst eine Firmendomain ein, und danach steht in der Zelle eine geschäftliche E-Mail-Adresse, eine Handynummer oder die Mitarbeiterzahl. Die Daten bezahlst du mit Data Credits. Die Mechanik drumherum bezahlst du mit Actions, und zwar pauschal: „Each record enriched or exported counts as 1 Action—regardless of data source or provider.“
Ein Wasserfall ersetzt den einen Anbieter durch eine Reihe von Anbietern. So weit erklären es alle Seiten zu diesem Suchbegriff. Was über deine Ergebnisse entscheidet, steht woanders. Es steckt in der Abrechnung an jeder Stufe, in einem Einstellungsdialog, den kaum jemand öffnet, und in drei Spalten, die Clay ausgeblendet ausliefert. Vorweg noch eine Offenlegung. Mir gehört ein Datenanbieter, der in diesem Verzeichnis steht. Den vorletzten Abschnitt liest du also besser mit etwas Abstand.
Was ist Wasserfall-Anreicherung?
Wasserfall-Anreicherung schickt einen Datensatz in fester Reihenfolge durch mehrere Anbieter und hält beim ersten Ergebnis an, das die Validierung besteht. Clays Leitfaden nennt das „a fallback chain, not a single lookup“. Findet ein Anbieter nichts, geht der Datensatz eine Stufe tiefer. In Clays Blog heißt dasselbe Prinzip data waterfall, „a sequential enrichment method where you query multiple data providers one after another“. Der Grund ist die Abdeckung. Kein einzelner Anbieter hat Daten für eine ganze Liste.
Eine Kette lohnt sich für jedes Feld, das mehrere Anbieter verkaufen: geschäftliche E-Mail-Adressen, Handynummern, Profil-URLs, Umsatz, Mitarbeiterzahl. Am schwierigsten sind Handynummern. Clay schreibt dazu, die Abdeckung „rarely clears 90 percent on any one source“. Wasserfälle laufen auf jedem Tarif, auch auf dem Gratis-Tarif mit 100 Data Credits, 500 Actions im Monat und 200 Zeilen je Tabelle. Bei monatlicher Zahlung beginnt Launch bei 185 $ im Monat mit 2.500 Credits und 15.000 Actions, Growth bei 495 $ mit 6.000 und 40.000. Clay veröffentlicht diese Preise in Dollar, deshalb stehen sie auch hier so. Beide Preisstaffeln vollständig: Clay-Preise.
Die Abrechnungsregel: jeder Schritt mit Ergebnis
Clay rechnet jeden Schritt ab, der etwas herausrückt. Nicht pauschal einmal je Zeile, und bei einer leeren Kette gar nicht. Vier Zustände sind möglich, und Clays FAQ dokumentiert alle vier.
| Was an einem Schritt passiert | Data Credits | Actions |
|---|---|---|
| Ein Anbieterschritt liefert Daten | verbraucht, „unless using API keys“ | 1 Action |
| Ein Validierungsschritt liefert ein Ergebnis | verbraucht, „unless using API keys“ | 1 Action |
| Validierte Daten sind angekommen | 0 für jeden Schritt darunter | 0 |
| Die ganze Kette liefert nichts | „no Data Credits or Actions will be consumed“ | 0 |
Lies zuerst die vierte Zeile. Bei ihr irren sich die meisten. Eine Kette, die nichts findet, kostet auch nichts, und deshalb schadet es kaum, sie tief zu staffeln. Dann die ersten beiden Zeilen, an denen die Annahme scheitert, eine Zeile in Clay koste genau eine Action. Findet schon die erste Stufe etwas, wird ein Schritt abgerechnet. Läuft der Datensatz über drei Stufen, sind es drei. Liefert ein Schritt eine Adresse, die deine Validierung danach ablehnt, wandert der Datensatz trotzdem weiter nach unten. Wie weit er wandert, legst du in den Einstellungen fest, und die liegen alle unter Full configuration.
Was eine Kette konkret kostet
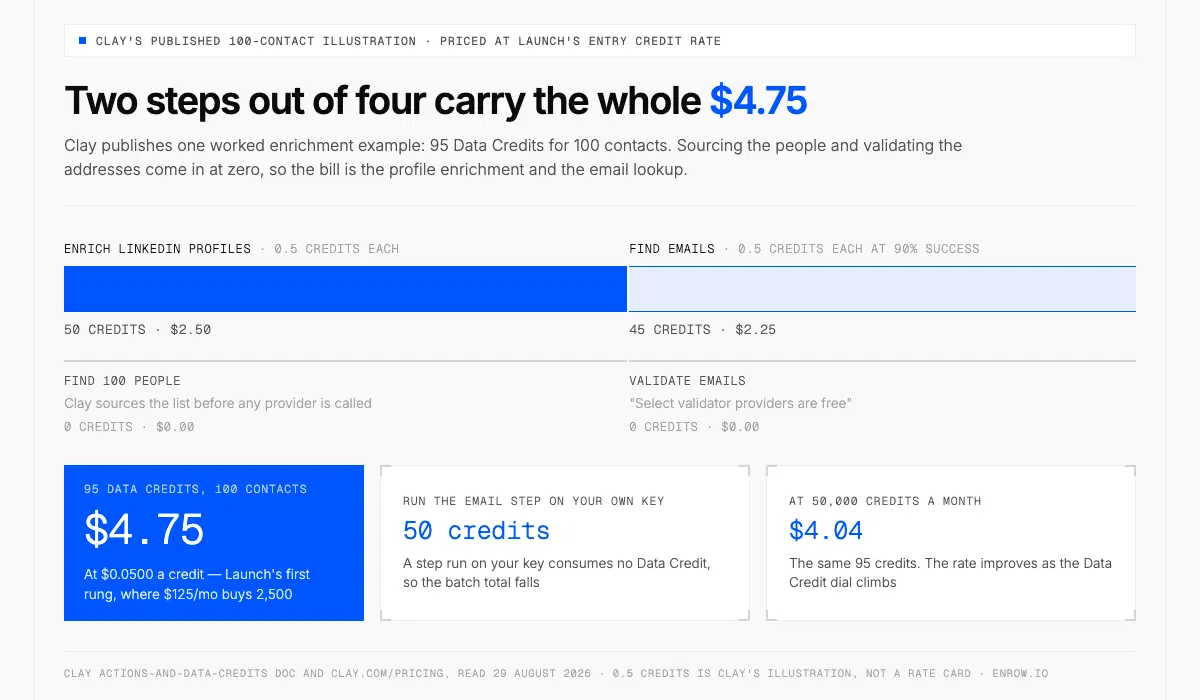
Nur zwei der vier Schritte kosten überhaupt etwas, zusammen kommen sie auf 4,75 $.
Clay veröffentlicht ein einziges durchgerechnetes Beispiel. Mit Clays Einstiegspreis je Credit gerechnet, kommen dabei 4,75 $ für 100 Kontakte heraus.
| Schritt in Clays Beispiel über 100 Kontakte | Data Credits | zu 0,0500 $ je Credit |
|---|---|---|
| 100 Personen finden | 0 Credits | 0,00 $ |
| LinkedIn-Profile anreichern, je 0,5 Credits | 50 Credits | 2,50 $ |
| E-Mail-Adressen suchen, je 0,5 Credits bei 90 % Trefferquote | 45 Credits | 2,25 $ |
| E-Mail-Adressen validieren, „select validator providers are free“ | 0 Credits | 0,00 $ |
| Summe | 95 Credits | 4,75 $ |
Läuft der E-Mail-Schritt über deinen eigenen Schlüssel, sinkt Clays Summe für dieselben 100 Kontakte auf 50 Data Credits. Zwei Vorbehalte zu dieser Rechnung. Die 0,5 Credits sind ein Beispielwert, keine Preisliste. Wörtlich steht in der Doku „Varies (0.5–10+ credits based on data type)“, ein vollständig angereicherter Datensatz liege „typically“ bei 6 bis 20 Credits. Der Satz von 0,0500 $ wiederum gilt für die unterste Stellung des Data-Credit-Reglers bei Launch, wo du für 125 $ im Monat 2.500 Credits bekommst. Weiter oben auf dem Regler wird es günstiger. Bei 50.000 Credits im Monat kosten dieselben 95 Credits 4,04 $.
Die Actions musst du selbst ausrechnen, denn Clay veröffentlicht kein durchgerechnetes Beispiel dafür, wie viele Actions ein Datensatz verbraucht, der drei Anbieter durchlaufen hat. Die Regel gibt dir die Rechnung trotzdem in die Hand: Zähl die Schritte, die etwas geliefert haben, Validierungsschritte eingerechnet. Angenommen, der erste Anbieter liefert eine Adresse, die bei der Validierung durchfällt, der zweite findet den Kontakt, und nach jedem der beiden läuft ein Validierungsaufruf. Das ergibt vier Actions, also 0,016 $ zum Satz von 0,0040 $, der bei Launch mit 15.000 Actions im Monat gilt. Teuer sind Actions nicht: „Each action costs a few tenths of a penny.“ Prüf die Zahl an zehn Zeilen nach. Clay zeigt die genauen Kosten neben jeder Option an, bevor etwas losläuft.
Die Reihenfolge der Anbieter und die Eingabespalten
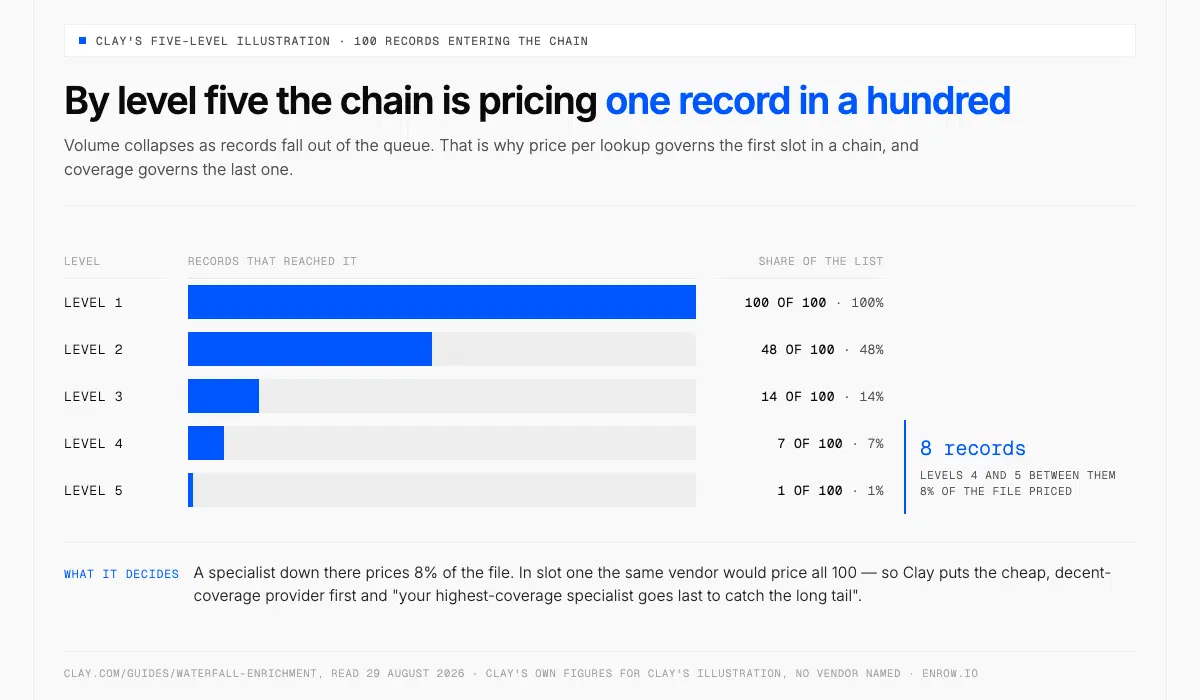
Nur einer von hundert Datensätzen erreicht Stufe fünf, deshalb entscheidet vorne der Preis und hinten die Abdeckung.
Bevor du an der Reihenfolge der Anbieter drehst, bring die Eingabespalten in Ordnung. Das kostet nichts und bringt mehr. Clay 101 schreibt: „The primary input required is the Company Domain. Ideally, also include Personal Linkedin URLs. If unavailable, use fallback combinations like Full Name + Company Name or Full Name + Personal Email.“ Steht im Domain-Feld der Name der Firma statt ihrer Domain, muss jede Stufe erst die Firma ermitteln, bevor sie nach der Person sucht. Die Ergebnisse sacken von oben nach unten ab, und am Ende bekommt die Reihenfolge der Anbieter die Schuld, obwohl sie nichts dafür kann. Ohne Domain läuft übrigens auch Infer Email nicht.
Dann die Reihenfolge. Von Stufe zu Stufe kommen schnell weniger Datensätze an, und deshalb entscheidet der Preis je Abfrage über den ersten Platz und die Abdeckung über den letzten. Clays Beispiel mit fünf Stufen über 100 Datensätze zeigt diesen Einbruch.
| Stufe in der Kette | Datensätze, die dort ankamen | Anteil der Liste |
|---|---|---|
| Stufe 1 | 100 von 100 Datensätzen | 100 % |
| Stufe 2 | 48 von 100 Datensätzen | 48 % |
| Stufe 3 | 14 von 100 Datensätzen | 14 % |
| Stufe 4 | 7 von 100 Datensätzen | 7 % |
| Stufe 5 | 1 von 100 Datensätzen | 1 % |
Auf den Stufen vier und fünf kamen zusammen acht Datensätze an. Ein Spezialanbieter dort unten stellt also 8 % deiner Liste in Rechnung. Auf Platz eins wären es alle 100.
Clays eigene Faustregel folgt dieser Kurve. Der Preis entscheidet über Platz eins: „Put a cheap, decent-coverage provider first and it clears the bulk of the list at the lowest price per record“, damit „your most expensive provider runs on the fewest records“. In der Mitte entscheidet die Qualität, gemessen an deiner Schwelle, denn eine zu großzügige Quelle, die die Kette früh anhält, kostet dich keine Zeile auf der Rechnung, sondern drei Wochen später einen Bounce. Am Ende entscheidet die Abdeckung, dort gilt „your highest-coverage specialist goes last to catch the long tail“.
Umsortieren kostet nichts. In Clays Doku heißt es, du könnest „reorder, add. or delete your waterfall data providers“ – der Tippfehler steht so bei Clay. Neben jedem Anbieter gibt es außerdem einen Schalter, mit dem du ihn überspringst, ohne ihn zu löschen. Gespeicherte Vorlagen dagegen „cannot be edited, only created and deleted“.
Die drei Stellschrauben in Full configuration
Legst du einen Wasserfall für geschäftliche E-Mail-Adressen an, lässt Clay dich zwischen Quick setup und Full configuration wählen. Jede Einstellung, die die Kosten beeinflusst, steckt in der zweiten Variante. Wegen der Abrechnung je Schritt sind alle drei keine Kosmetik, sondern Kostenbremsen.
| Stellschraube | Voreinstellung | Was sie verändert |
|---|---|---|
| Infer email | ein Schalter, „Include infer-email enrichment as first step?“ | eine kostenlos aus dem Adressformat der Firma abgeleitete Adresse vor jedem bezahlten Anbieter; besteht sie die Validierung, „the waterfall stops immediately“ |
| Validierung | vier Strategien plus der Schalter „Require validation success?“ | was gut genug ist, damit die Kette anhält |
| Threshold for duplicate results | 0, also abgeschaltet | „Set to 2 or higher to stop the waterfall after the same invalid email appears that many times“ |
Zur ersten Stellschraube ist Clay eindeutig: „Infer Email is completely free. The validation step does cost Clay credits, but it is cheaper than running the waterfall without it.“ Voreingestellt ist das Format first.last@domain.com, und in Clays internem Test an Software-Firmen lieferte der Schritt „a valid email roughly 31% of the time“. Knapp ein Drittel der Testdaten war damit erledigt, bevor ein bezahlter Anbieter überhaupt anlief. Wie hoch dein eigener Wert ausfällt, hängt davon ab, wie konsequent die Firmen in deinem Segment ihre Adressen nach einem festen Format vergeben.
Die eigentliche Bremse ist die Validierungsstrategie, und Clay fasst den Zielkonflikt in einem Satz zusammen: „too strict and you'll over-spend chasing elusive emails; too loose and you'll accept results that bounce.“ Von den vier Einstellungen ist Conservative die, die Clay für Cold Email vorsieht. Die anderen drei erkaufen Reichweite mit einer niedrigeren Latte.
| Strategie | Clays Beschreibung | Nimm sie, wenn |
|---|---|---|
| Conservative | „The safest approach, including all verified email types“ | du Cold Email verschickst, „where bounce rates affect sender reputation“ |
| Balanced | „Moderate risk level, including catch-alls“ | Catch-all-Domains einen großen Teil deiner Liste ausmachen |
| Aggressive | „Higher risk level, good for casting a wide net“ | „volume and coverage take priority over precision“ |
| Advanced | „Manual configuration for fine-grained control“ | du schon weißt, welche Adresstypen du akzeptierst |
Daneben gibt es den Schalter „Require validation success?“. Damit zählt eine Adresse nur, wenn der Validierer sie ausdrücklich als gültig bestätigt („explicitly confirms it as valid“). Am selben Schalter hängen auch die Catch-all-Adressen. Clay wertet sie ab Werk als gültig und prüft sie laut Clay 101 standardmäßig über ZeroBounce. Der Schalter „Only mark 'Safe to Send' emails as valid“ sortiert sie wieder aus. Ob Catch-all-Domains auf eine Versandliste gehören, ist eine Frage für sich.
Der Schwellenwert für Dubletten greift direkt in die Abrechnung ein. Clay zur Voreinstellung: „Left at 0, the waterfall will continue through every provider, spending credits on a result it's already decided to reject.“ Stellst du ihn auf 2, hält die Kette an, sobald dieselbe abgelehnte Adresse zum zweiten Mal auftaucht, „especially useful when paired with the Conservative strategy“. Denn gerade dort schickt die strenge Latte die meisten Datensätze weiter nach unten.
Zeilen aussortieren, die die Anreicherung nie wert waren
Ein kompletter Fehlschlag kostet nichts, dort geht also kein Geld verloren. Verloren geht es bei Zeilen mit brauchbaren Antworten, die hinterher niemand nutzt: der doppelt angelegte Account, die private Adresse, der Kontakt, der im März gekündigt hat.
Die Mechanik dazu steht in Clays Leitfaden zum Credit-Sparen. Knüpf die Spalte unter Run Settings an eine Bedingung („Only run if“), und über den Knopf Use AI formulierst du die Regel im Klartext. Lass die automatische Aktualisierung aus, solange du die Tabelle noch einrichtest, denn eine Spalte läuft erneut, „whenever its input values change“. Gefilterte Ansichten reichern nur die Zeilen an, die du gerade vor dir hast, und eine Lookup-Spalte liest nach, was in einer anderen Tabelle oder in deinem CRM längst steht, bevor du dasselbe ein zweites Mal kaufst. Hinterlegst du eigene Anbieterschlüssel, sagt die Preisseite klar, was sich ändert: „Each run will count as one Action, but no Data Credit will be used.“ Clays Doku beziffert die Ersparnis bei den Data Credits auf 50–80 %. Prüf, ob die Funktion in deinem Tarif enthalten ist, bevor du eine ganze Tabelle darauf aufbaust. Preisseite und Spar-Leitfaden beschreiben die Verfügbarkeit unterschiedlich, und im Zweifel entscheidet das Produkt. Für diese Verkabelung ist die E-Mail-Finder-API zuständig.
Nachlesen, was die Kette getan hat
Die drei Spalten, mit denen ein Wasserfall überhaupt nachprüfbar wird, sind ab Werk alle ausgeschaltet. „Output name of successful provider?“ legt eine Spalte an, in der steht, welcher Anbieter das jeweilige Ergebnis geliefert hat. „Hide provider columns?“ ist standardmäßig aktiv. Dazu schreibt Clay 101: „Validation columns are hidden by default. Open the Columns Panel and unhide these columns to inspect detailed validation steps.“ Schalt die erste ein, bevor du das nächste Mal größere Mengen laufen lässt. Sonst rätst du die Reihenfolge deiner Anbieter jedes Quartal neu, ohne jede Datengrundlage.
Für die Ausgaben gibt es eigene Anzeigen, und die nützliche ist nicht die, die zuerst aufgeht. Unter Settings → Usage siehst du den ganzen Workspace, filterbar nach Datum, Eigentümer und Integration, exportierbar als CSV. Die Oberfläche auf Tabellenebene erreichst du über das Credits-Fenster oder den Knopf Table History. Dort liegt Column view: „your spend broken down by each column in your table, helping you identify which enrichments are using the most credits.“ Daneben stehen Time view und Run view. Eine Einschränkung, bevor du suchst: „Historical data for the table credit dashboard begins on November 5th, 2025.“
Wie tief ist tief genug
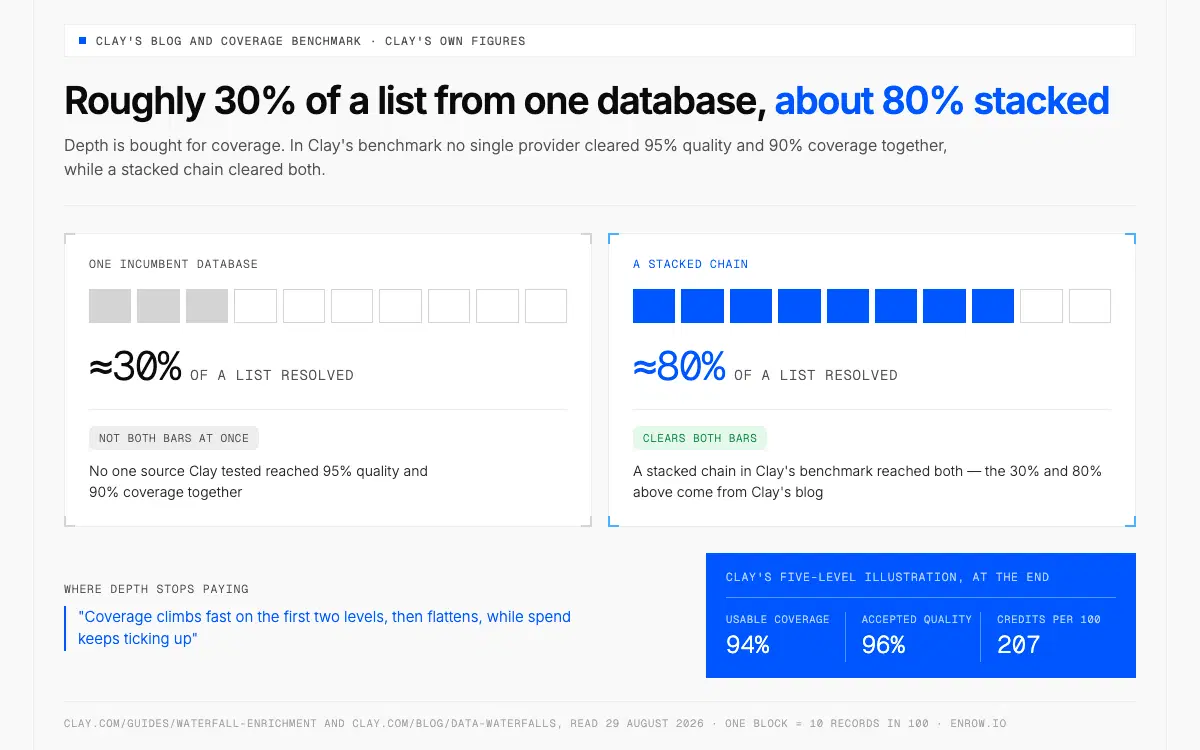
In Clays Benchmark schafft kein einzelner Anbieter 95 % Qualität und 90 % Abdeckung zugleich, eine gestapelte Kette schon.
Mehr Stufen bringen mehr Abdeckung, allerdings nur auf den ersten beiden; danach flacht die Kurve ab. Clay beschreibt sie selbst: „Coverage climbs fast on the first two levels, then flattens, while spend keeps ticking up.“ Auch deine Schwelle verändert diese Kurve: „A stricter cutoff rejects borderline matches, so quality climbs while coverage dips and cost rises.“ Für Cold Email rät Clay zur strengen Einstellung, weil eine falsche Adresse schlimmer ist als eine fehlende. Da widerspreche ich nicht.
Das Argument für mehrere Stufen stammt von Clay, gemessen von Clay an Clays eigenen Daten, und es ist stark. Laut Clays Benchmark schafft kein einzelner Anbieter 95 % Qualität und 90 % Abdeckung zugleich, eine mehrstufige Kette dagegen schon. Das Beispiel mit fünf Stufen endet bei 94 % brauchbarer Abdeckung, bei mittlerer Schwelle mit 96 % akzeptierter Qualität und 207 Data Credits auf 100 Datensätze: 10,35 $ zum Einstiegssatz, 8,80 $ bei 50.000 Credits im Monat. Clays Blog zeigt dasselbe Bild von der anderen Seite: Eine etablierte Datenbank allein deckt rund 30 % einer Liste ab, eine mehrstufige Kette etwa 80 %.
Clay bemisst seine Tarife in Datensätzen je Monat statt in Credits. Das ist die ehrlichere Einheit, sobald der Credit-Preis eines Datensatzes von der Kette dahinter abhängt. Launch ist danach auf etwa tausend Datensätze im Monat ausgelegt, Growth auf eintausend bis zehntausend.
| Tarif | Data Credits je Monat | Clays eigene Richtgröße |
|---|---|---|
| Launch | 2.500–10.000 Credits/Monat | „~1,000 records/month“ |
| Growth | 6.000–100.000 Credits/Monat | „1,000–10,000 records/month“ |
| Enterprise | ab 100.000 Credits/Monat | „10,000+ records/month“ |
Einen Vorbehalt hängt Clay daran: „The more API keys you connect, the fewer Data Credits you'll need.“ Zur selben Entscheidung gehören noch zwei Zahlen. Nicht verbrauchte Data Credits werden bei Launch und Growth bis zum Doppelten der Monatsmenge übertragen, ein ruhiger Monat finanziert also einen vollen. Ein einzelner Massenlauf über 50.000 Datensätze hinaus bleibt Enterprise vorbehalten.
Wo eine verifizierte Quelle in die Kette gehört
Eine Kette bewertet einen Anbieter nach engeren Kriterien als ein Einkäufer. Sie fragt, wie schnell die Antwort kommt und wie sie aussieht, wenn es nichts zu finden gibt.
Enrow steht seit dem 1. September 2024 in Clays Verzeichnis, als von Clay entwickelte Integration unter Contact Data und Contact Data Verification. Drei Aktionen: geschäftliche E-Mail-Adresse finden, Handynummer finden, geschäftliche E-Mail-Adresse validieren, wobei der Eintrag die dritte als Free Action führt. Die beiden Finder laufen wahlweise über Clay-Credits oder über einen Enrow-Zugang, den du selbst hinterlegst. Antworten kommen in zwei bis fünf Sekunden zurück, die Spalte hält also keinen Tabellenlauf auf, und wir berechnen einen Credit erst, wenn ein gültiges Ergebnis zurückkommt. Eine Adresse auf einer Catch-all-Domain prüfen wir so lange, bis eindeutig feststeht, ob das Postfach existiert. Sie landet danach als brauchbares Ergebnis in der Zelle, statt als riskant abgestempelt und aussortiert zu werden. Dafür sorgen unter anderem die über zehn Prüfungen hinter jeder Adresse.
Drei Grenzen entscheiden, auf welchen Platz die Spalte gehört. Die erste wiegt gerade hier schwer. Clays Wasserfall dreht sich um eine einstellbare Schwelle, und eine Enrow-Spalte liefert dieser Schwelle ein Urteil statt einer Zahl. Das Feld Qualification sagt gültig oder nicht gültig, ohne Confidence-Score, an dem du selbst eine Grenze ziehen könntest. Wir halten diese Schwelle bewusst auf unserer Seite, weil ein Score eine Einschätzung ist, die du am Ende jemandem gegenüber verteidigen müsstest, der für die Zustellbarkeit deiner Domain geradesteht. Auf einer Plattform, die fürs Feinjustieren gemacht ist, ist das ein spürbarer Nachteil.
Zweitens liegt keine Datenbank dahinter. Enrow sucht die Kontaktdaten zu einer Person, die du schon benannt hast, den Platz fürs Sourcing besetzen wir also nicht. Clays kostenloser Schritt Find People, ein CRM-Sync oder eine CSV liefern Namen und Domain vorher. Ein eingelagerter Index fängt am Tag seiner Erstellung an zu altern, und ich verkaufe dir lieber nichts aus dem letzten Quartal.
Drittens läuft alles aus einem gemeinsamen Topf: Eine E-Mail-Adresse kostet einen Credit, eine Handynummer 40, eine Verifizierung ein Viertel. Lässt du eine E-Mail-Spalte und eine Telefonspalte über dieselben 5.000 Zeilen laufen, nehmen sie sich gegenseitig das Budget weg.
Welche Quellen überhaupt einen Platz verdienen, wie sie abrechnen, wer die Trefferquote gemessen hat, was bei einer Catch-all-Domain passiert und ob die EU-Abdeckung dokumentiert ist, klärt der Artikel So wählst du einen B2B-Datenanbieter. Alles, was vor der Anreicherungsspalte passiert, steht in So nutzt du Clay.
Öffne Full configuration in deiner Spalte für geschäftliche E-Mail-Adressen. Infer Email an, Schwellenwert für Dubletten auf 2, Ausgabe des erfolgreichen Anbieters an, dann zehn Zeilen laufen lassen und nachlesen, was zurückkam. Am Monatsende machst du Column view auf und schaust nach, ob deine beiden untersten Anbieter überhaupt etwas gefunden haben. Meistens hat einer davon nichts geliefert, und ihn zu verschieben dauert fünf Sekunden, sobald du es siehst.
Am Ersten jedes Monats landen 50 Enrow-Credits in deinem Konto. Kostenlos, und niemand fragt nach einer Kreditkarte: enrow.io. Soll der Schritt über deinen eigenen Schlüssel laufen, geht das über die API, die dir mit jedem Kauf offensteht: einem Tarif ab 15 € im Monat oder einem Credit-Paket ohne Abo.
bereit, keine zeit mehr zu verschwenden?
Verbunden in Minuten.
Verifizierte Daten in Sekunden.
FAQ
Was ist Datenanreicherung in Clay?
Datenanreicherung in Clay ist eine Spalte, die einen externen Anbieter aufruft und dessen Antwort in die Zeile schreibt. Du gibst eine Firmendomain ein und bekommst eine geschäftliche E-Mail-Adresse, eine Handynummer oder ein Firmenfeld zurück, geliefert von einem der 150+ Anbieter, die Clays Preisseite ausweist. Jeder angereicherte Datensatz kostet eine Action plus die Data Credits des Anbieters.
Wie werden Credits in einem Clay-Wasserfall abgerechnet?
Clay rechnet einen Wasserfall Schritt für Schritt ab. Jeder Schritt, der Daten liefert, verbraucht Data Credits und eine Action, es sei denn, er läuft über deinen eigenen API-Schlüssel; für jeden Validierungsschritt mit Ergebnis gilt dasselbe. Sobald validierte Daten angekommen sind, verbrauchen die Anbieter darunter nichts mehr.
Kostet es etwas, wenn ein Anbieter im Wasserfall nichts findet?
Nein. In Clays FAQ steht, dass weder Data Credits noch Actions verbraucht werden, wenn der gesamte Wasserfall ohne Ergebnis bleibt, und die Preisseite wiederholt diese Regel allgemein für Anreicherungen. Berechnet werden nur Schritte, die etwas herausrücken, und deshalb zahlen sich die zehn Minuten für die Validierungseinstellungen aus.
Lohnt sich Wasserfall-Anreicherung?
Der Ertrag heißt Abdeckung, und Clays eigener Benchmark ist der deutlichste Beleg dafür. Kein einzelner Anbieter schaffte 95 % Qualität und 90 % Abdeckung zugleich, eine mehrstufige Kette schaffte beides. Clays veröffentlichtes Beispiel landet bei 94 % brauchbarer Abdeckung. Am meisten bringen die ersten beiden Stufen, danach flacht die Kurve ab.
Was ist Infer Email in Clay, und kostet es Credits?
Infer Email schiebt einen kostenlosen ersten Schritt davor, der aus dem Namen einer Person und der Firmendomain eine Adresse bildet, standardmäßig nach dem Format first.last@domain.com. Besteht sie die Validierung, hält der Wasserfall an, bevor ein bezahlter Anbieter läuft. Clays interner Test mit einem Datensatz aus der Softwarebranche lieferte in rund 31 % der Fälle eine gültige Adresse.
Welche Validierungsstrategie soll ich in einem Clay-Wasserfall nehmen?
Clay bietet vier an. Conservative deckt alle verifizierten Adresstypen ab und passt zu Cold Email, wo Bounces der Absenderreputation schaden. Balanced lässt Catch-all-Adressen zu. Aggressive wirft ein weites Netz aus, wenn Abdeckung vor Genauigkeit geht. Advanced ist die manuelle Konfiguration. Für Cold Email rät Clay selbst zur strengen Schwelle.
In welcher Reihenfolge gehören die Anbieter in einen Clay-Wasserfall?
Clays Faustregel hat drei Teile. Der Preis je Abfrage entscheidet über Platz eins, denn ein günstiger Anbieter mit ordentlicher Abdeckung erledigt den Großteil der Liste zu den niedrigsten Kosten je Datensatz. In der Mitte entscheidet die Qualität, gemessen an deiner Schwelle. Der Spezialanbieter mit der höchsten Abdeckung kommt zuletzt und fängt die schwer auffindbaren Kontakte ab.
Welche Eingaben braucht ein E-Mail-Wasserfall in Clay?
Die Firmendomain ist laut Clay 101 die wichtigste Eingabe, im Idealfall ergänzt um die LinkedIn-Profil-URL der Person. Fehlen beide, nennt Clay Ersatzkombinationen: vollständiger Name plus Firmenname oder vollständiger Name plus private E-Mail-Adresse. Infer Email braucht zwingend eine Domain, Listen mit bloßen Namen überspringen diesen Schritt.
Wie viele Anbieter gehören in einen Clay-Wasserfall?
So viele, dass auch die schwer auffindbaren Kontakte abgedeckt sind, und Clays Beispiel mit fünf Stufen zeigt, dass das weniger sind als gedacht. Auf Stufe eins kamen alle 100 Datensätze an, auf Stufe zwei 48, auf Stufe drei 14, auf Stufe vier sieben und auf Stufe fünf noch einer. Die Abdeckung steigt auf den ersten beiden Stufen schnell und flacht danach ab, während die Ausgaben weiterlaufen.