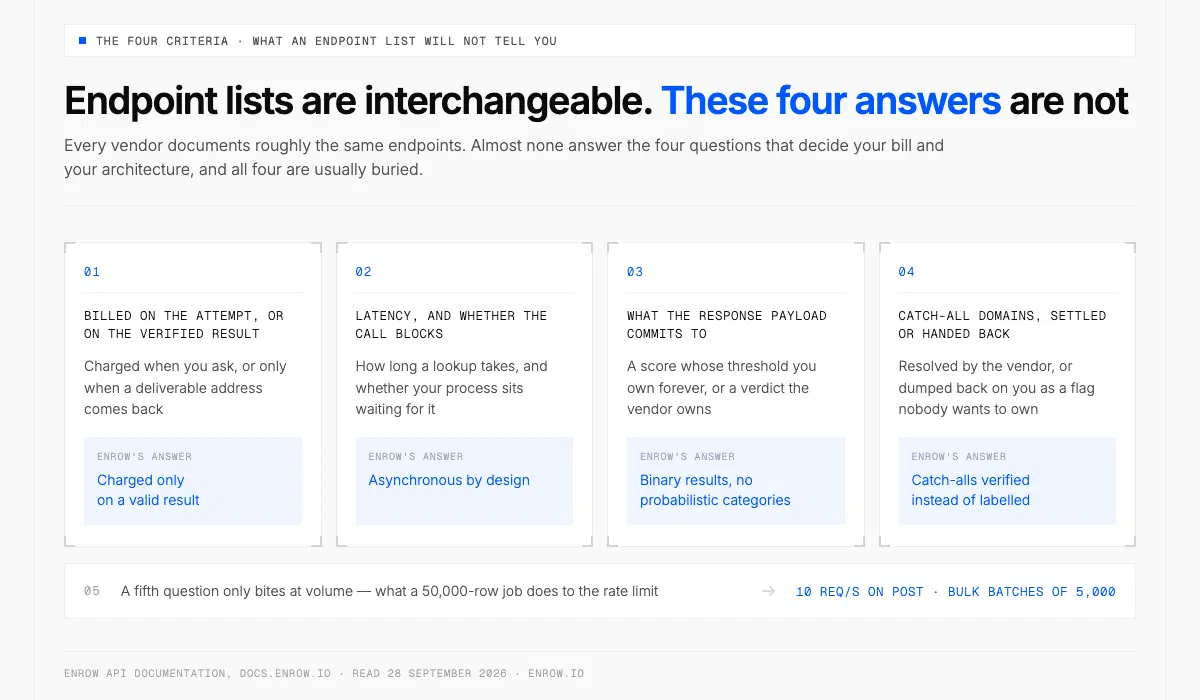
Die Endpoints gleichen sich bei allen Anbietern; die vier Antworten, die über deine Rechnung entscheiden, gibt kaum einer.
Das Wichtigste in Kürze Einer Email-Finder-API übergibst du eine Person, die du schon identifiziert hast, meistens Name plus Firma, und bekommst dafür eine verifizierte geschäftliche E-Mail-Adresse. Die Endpoints sehen bei allen Anbietern ungefähr gleich aus. Vier Fragen beantwortet fast keiner, und genau die entscheiden über deine Rechnung und über deine Architektur. Wird der Versuch abgerechnet oder das geprüfte Ergebnis? Wie lange dauert eine Suche, und blockiert sie dabei? Worauf legt sich die Antwort tatsächlich fest? Klärt der Anbieter eine Catch-all-Domain, oder bleibt sie an dir hängen? Eine fünfte Frage tut erst bei großen Mengen weh: Wie verträgt sich ein Lauf über 50.000 Zeilen mit dem Rate-Limit? Enrows Antworten, zum Vergleich: berechnet wird nur ein gültiges Ergebnis, jeder Endpoint arbeitet asynchron, Catch-all-Adressen werden geprüft statt nur markiert, 10 POST-Anfragen je Sekunde, Bulk-Läufe bis 5.000 Zeilen. Lies die Abrechnungszeile vor der Feature-Liste. Sie entscheidet über die echten Kosten mehr als der Listenpreis.
Eine Email-Finder-API ist ein HTTP-Endpoint, der zu einer Person die geschäftliche E-Mail-Adresse ermittelt. Du schickst einen Namen und eine Firma hin. Heraus kommt eine Adresse, dazu irgendeine Aussage darüber, ob es sie gibt.
Vorweg eine Abgrenzung, weil die Suche nach „email api“ überwiegend etwas anderes ausspuckt: Versanddienste und Relays für Transaktions-E-Mails. Die sind für den Versand da. Eine Finder-API klärt vorher, welche Adresse zu einer Person gehört, und zu diesem Zeitpunkt existiert noch gar keine Nachricht.
Die vier Kriterien unten sind entstanden, während wir unsere eigene API entwickelt und nebenbei die Dokumentation von einem Dutzend Wettbewerbern gelesen haben. Endpoint-Listen sind austauschbar. Das Abrechnungsmodell, die Zusage zur Latenz, die Form der Antwort und der Umgang mit Catch-all-Adressen sind es nicht, und alle vier sind meist gut versteckt. Die Bulk-Obergrenze zählt ebenfalls, aber erst, wenn ernsthaft Volumen durchläuft. Deshalb bekommt sie im Anschluss einen eigenen Abschnitt.
1. Zahlst du für den Versuch oder für das geprüfte Ergebnis?
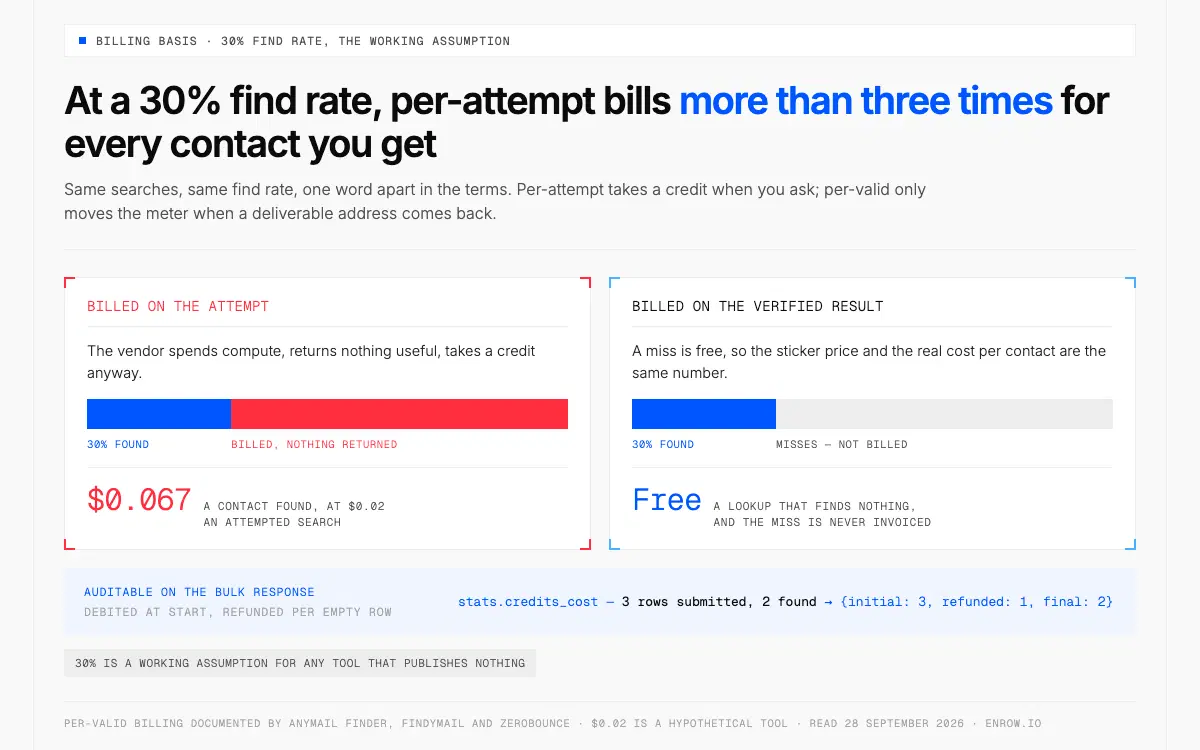
Zahlst du für Fehlschläge mit, kostet dich jeder gefundene Kontakt mehr als das Dreifache einer einzelnen Suche.
Daran hängt alles. Und genau diese Angabe fehlt auf den meisten Preisseiten.
Es gibt zwei Modelle. Beim Preis je Versuch kostet schon die Anfrage: Der Anbieter wendet Rechenzeit auf, findet nichts Brauchbares und bucht trotzdem einen Credit ab. Beim zweiten Modell zahlst du nur für ein verifiziertes Ergebnis: Ein Fehlschlag kostet nichts, und der Zähler springt erst an, wenn eine zustellbare Adresse da ist.
Der Unterschied ist keine Rundungsdifferenz. Trefferquoten auf kalten B2B-Listen liegen deutlich unter der Hälfte. Für jedes Tool, das dazu nichts veröffentlicht, sind 30 % die faire Arbeitsannahme. Bei 30 % zahlst du im Modell je Versuch für jeden Kontakt, den du am Ende hast, mehr als das Dreifache. Danach bouncet ein Teil der Treffer, und dafür hast du auch schon bezahlt.
Ein paar Anbieter halten dieses Modell schriftlich fest, und das ist etwas wert. Anymail Finder zieht einen Credit erst ab, wenn die Adresse verifiziert ist. Bei Findymail gilt dasselbe, ein Credit für eine gefundene Adresse. ZeroBounce berechnet die erfolgreiche Suche und verlangt für eine ungeklärte nichts.
Enrows Finder-Endpoints arbeiten genauso, und im Bulk lässt sich die Abrechnung nachprüfen. Ein Bulk-GET liefert stats.credits_cost als drei Zahlen: initial, refunded, final. Beim Start des Laufs werden Credits abgebucht, danach gibt es für jede leere Zeile eine Gutschrift. Das dokumentierte Beispiel schickt 3 Zeilen los, findet 2 und schließt mit {initial: 3, refunded: 1, final: 2} ab. So gleichst du die Ausgaben eines Monats mit den gefundenen Zeilen ab, ohne ein Support-Ticket aufzumachen.
Ein Punkt spricht allerdings in die andere Richtung. Enrows Email Verifier rechnet je Prüfung ab, 0,25 Credit, nicht je gültiges Ergebnis. Schickst du ungültige Adressen hinein, zahlst du die 0,25 trotzdem für jede Zeile. Beim Finden wird nur ein gültiges Ergebnis berechnet, beim Prüfen jede einzelne Anfrage. Das solltest du wissen, bevor du eine Listenbereinigung über den falschen Endpoint laufen lässt.
2. Latenz und die Frage, ob der Aufruf blockiert
Zwei Entwurfsansätze stehen sich gegenüber, und keiner davon ist falsch.
Manche APIs antworten synchron. Anymail Finder gibt für eine Einzelsuche meist rund drei Sekunden an. Hunter macht aus diesem Zielkonflikt einen Parameter: max_duration, zwischen 3 und 20 Sekunden, Standardwert 10, und die Doku schreibt dazu, dass eine längere Dauer die Ergebnisse verfeinert und genauere Daten hergibt. Ein ungewöhnlich ehrlicher Regler. Genauigkeit kostet Millisekunden, und Hunter lässt dich entscheiden, wie viele du davon ausgibst.
Bei Enrow haben wir uns anders entschieden. Jeder Endpoint arbeitet asynchron. Ein POST auf /email/find/single antwortet sofort mit einer Such-ID, das Ergebnis kommt später per Webhook oder über den passenden GET. Die Doku sagt ausdrücklich, dass das Absicht ist: Große Mengen sollen den Aufrufer nie blockieren. Solange eine Suche läuft, liefert der GET {"qualification": "ongoing"}.
Die Prüfung selbst ist in Sekunden durch. Dein Ablauf wartet trotzdem nicht darauf, und Code, der die Adresse in der POST-Antwort erwartet, findet sie dort nicht.
Was besser passt, hängt davon ab, an welcher Stelle die Suche läuft. In einem Formular, das ein Mensch gerade ausfüllt, ist ein synchroner Aufruf von drei Sekunden völlig in Ordnung. In einem Nachtlauf über 40.000 Zeilen wird ein blockierender Aufruf zum Risiko. Für den zweiten Fall gibt es RFC 9110 §15.3.3: 202 Accepted bedeutet „zur Verarbeitung angenommen, aber noch nicht abgeschlossen“.
Einen p95 veröffentlicht niemand. Enrow nicht, die Anbieter oben auch nicht. Im Marketing steht „in Sekunden“, und auf ein Perzentil legt sich keiner fest. Miss das mit deinem eigenen Volumen nach, bevor du deine Architektur auf eine Zahl von einer Landingpage stützt.
3. Was die Antwort verbindlich aussagt
Hier teilt sich der Markt in zwei Schulen, und die falsche Wahl kostet dich Wochen an Entwicklungszeit.
Die erste Schule reicht die Unsicherheit an dich weiter. Hunters Email Finder meldet einen score von 0 bis 100, ein accept_all als Boolean, ein verification-Objekt mit dem Status valid, accept_all oder unknown, dazu bis zu zwanzig Einträge unter sources, jeder mit der Seite, auf der die Adresse aufgetaucht ist, und den Datumsfeldern extracted_on und last_seen_on. Was der Score auf einer Accept-all-Domain bedeutet, sagt die Doku offen: Er schätzt die Wahrscheinlichkeit, dass die Adresse gültig ist. ZeroBounce macht dasselbe gröber und meldet email_confidence als HIGH, MEDIUM oder LOW, dazu einen von neun Werten unter failure_reason.
Das ist brauchbar, wenn du deine eigene Bewertungsschicht entwickelst. Das sources-Array ist ein ernstzunehmendes Werkzeug für die Spurensuche.
Die zweite Schule klärt die Frage und liefert dir ein Urteil. Enrows Finder meldet qualification als valid oder invalid, während der Suche ongoing. Die Doku sagt es unverblümt: binäre Ergebnisse, keine Wahrscheinlichkeitsklassen. Daneben stehen email, ein info-Block mit Firmendomain, Firmenname, Vor- und Nachname, und das custom-Objekt, das du mitgeschickt hast.
Die richtige Frage ist nicht, welche Antwort mehr Felder hat. Sie lautet: Wem gehört der Schwellenwert? Kommen 0 bis 100 und accept_all: true heraus, gehört er dir, und zwar dauerhaft. Jeder Vertriebler, der sich dann über einen Bounce beschwert, beschwert sich über eine Zahl, die du gesetzt hast. Kommt valid oder invalid heraus, gehört der Schwellenwert dem Anbieter, und du kannst ihn beim Wort nehmen.
Das custom-Objekt macht eine ganze Sorte Glue-Code überflüssig. Was immer du hineinschreibst, je Anfrage und im Bulk je Zeile, steht unverändert in der GET-Antwort und im Webhook. Interne Kontakt-ID, Kampagnen-Kennzeichen, Datensatz-ID aus dem CRM, was auch immer dein Ablauf als Schlüssel nutzt. Eine Zuordnungstabelle brauchst du nicht.
4. Catch-all-Domains: geklärt oder dir überlassen
Eine Accept-all-Domain sagt zu jeder Adresse, die man ihr vorlegt, Ja. Echtes Postfach, Tippfehler, blanker Unsinn, alles wird angenommen. Das ist kein Versagen eines Anbieters, sondern steht im Protokoll. RFC 5321 §3.5.3 rechnet damit: Es gibt Fälle, in denen eine Adresse gültig aussieht, sich in Echtzeit aber nicht sinnvoll prüfen lässt, und dann soll der Server mit 252 antworten. §3.3 hält außerdem fest, dass manche Server den Empfänger erst prüfen, wenn der Nachrichtentext eintrifft. Eine angenommene Adresse kann also später trotzdem bouncen.
Mit einer einzelnen SMTP-Abfrage ist das nicht zu klären. Das liegt am Protokoll und nicht an einer Lücke im Werkzeug.
Die meisten APIs schieben dir die Unklarheit deshalb zu. Hunters Verifier meldet accept_all, und die Doku von Hunter warnt selbst, dass ein SMTP-Server, der alles annimmt, bei SMTP-Prüfungen zu falsch positiven Ergebnissen führen kann. Das ist ehrlich. Übrig bleibt bei dir trotzdem ein Stapel Zeilen, für den niemand zuständig sein will.
Wirf diesen Stapel nicht weg. In B2B-Listen sind gerade die Firmen überrepräsentiert, die am ehesten alles annehmen, und wer allein wegen dieser Markierung löscht, wirft erreichbare Entscheider zusammen mit den ungültigen Zeilen hinaus.
Enrow klärt Catch-all-Adressen, statt sie zu markieren: wiederholte SMTP-Durchläufe von Servern aus verschiedenen Regionen, abgeglichen mit absichtlich erfundenen Kontrolladressen auf derselben Domain, als Teil der 10+ Prüfungen hinter jedem Ergebnis. Was sich klären lässt, kommt als valid heraus und wird als Treffer berechnet. Was sich nicht klären lässt, kommt als invalid heraus und kostet nichts. Die Catch-all-Prüfung steckt im Credit-Preis und ist kein Zusatzprodukt. Die beobachtete Bounce-Rate liegt unter 1 %, ein Durchschnittswert aus echtem Versand und keine Zusage. Die Mechanik dahinter steht in Was ist eine Catch-all-Adresse, die Folgen für die Zustellbarkeit in Bounce-Rate bei E-Mails.
Bulk Email Finder: die Endpoints und ihre Rate-Limits
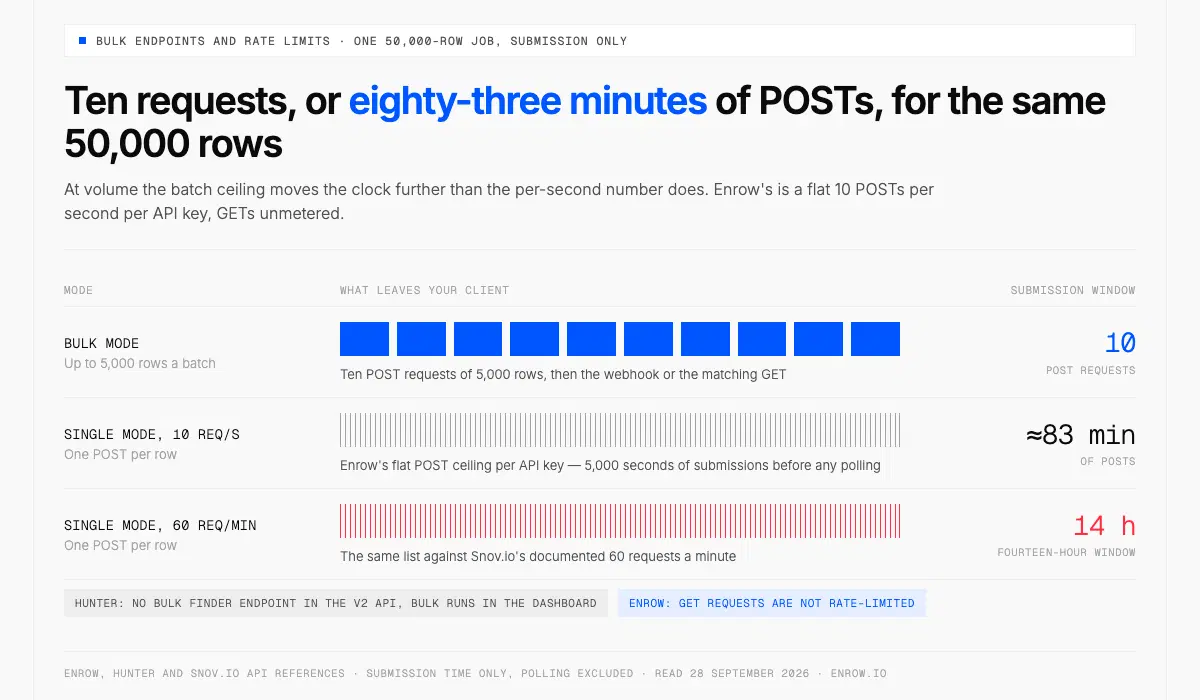
Bei großen Mengen zählt die Stapelgröße mehr als das Limit je Sekunde: zehn Anfragen statt rund 83 Minuten POSTs.
Ein Bulk Email Finder ist ein Endpoint, der eine ganze Kontaktliste in einer einzigen Anfrage annimmt und die verifizierten Adressen als Stapelauftrag ausliefert, statt einen HTTP-Aufruf je Person zu verlangen. Daran hängt, ob ein Ablauf über Nacht fertig wird oder eben nicht.
Die Obergrenzen je Stapel und die Rate-Limits unterscheiden sich stark, und sie greifen ineinander.
| Anbieter | Bulk Finder | Veröffentlichtes Rate-Limit |
|---|---|---|
| Enrow | Bis zu 5.000 Zeilen je Stapel (3.000 bei Telefonnummern) | 10 Anfragen/s auf allen POST-Endpoints; GET nicht begrenzt |
| Hunter | Kein Bulk-Finder-Endpoint in der v2-API; Massenläufe finden in der Oberfläche statt | Email Finder 15 Anfragen/s und 500/Min.; Verifier 10 Anfragen/s und 300/Min. |
| Anymail Finder | Bis zu 100.000 Zeilen je Auftrag, Ergebnisse per Webhook (Anbieterangabe) | Keine Tages- oder Stundengrenzen (Anbieterangabe, kein SLA veröffentlicht) |
| Snov.io | Bulk-Suche ist ein Produkt-Feature; die API-Referenz beschreibt keinen Stapel-Endpoint | 60 Anfragen je Minute |
Rechne einen Lauf über 50.000 Zeilen einmal durch. Bei Einzelsuchen und einer Grenze von 10 Anfragen je Sekunde dauert allein das Absenden 5.000 Sekunden, also rund 83 Minuten nur für POSTs, bevor überhaupt jemand nach einem Ergebnis fragt. Im Bulk braucht derselbe Lauf zehn Anfragen. Mit Snovs dokumentierten 60 Anfragen je Minute zieht sich der Einzelmodus über vierzehn Stunden.
Bei großen Mengen zählt die Stapelgröße also mehr als das Limit je Sekunde. Enrows Grenze liegt pauschal bei 10 POSTs je Sekunde und API-Schlüssel, GETs werden nicht gezählt, und eine Anhebung gibt es auf Anfrage über api@enrow.io. Eine höhere Zahl ist nirgends veröffentlicht, plane also nicht damit.
Wiederholungsversuche, Idempotenz und was die Abrechnung daran ändert
POST ist nicht idempotent. RFC 9110 §9.2.2 erlaubt einem Client, eine Anfrage zu wiederholen, wenn keine Antwort ankommt, setzt dafür aber voraus, dass die Anfrage als idempotent gelten darf. Auf einen Such-POST trifft das nicht zu. Schickst du eine Anfrage nach einem Timeout erneut ab, ist das ein zweiter abrechenbarer Vorgang, solange der Anbieter die Dublette nicht selbst erkennt.
Der Header, nach dem jeder greift, ist kein Standard. Idempotency-Key ist ein IETF-Entwurf, draft-ietf-httpapi-idempotency-key-header, der mit Revision 07 ausgelaufen ist. Ob er unterstützt wird, entscheidet jeder Anbieter für sich, und die Abdeckung ist lückenhaft. Hunter setzt ihn sauber um, mit 24 Stunden TTL, einem Fingerabdruck über den Request-Body und vier verschiedenen Fehlercodes, aber nur auf den Endpoints für Sequenzen und Nachrichten. Beim Email Finder fehlt er.
Beim Preis je Versuch ist das ein echtes Problem. Die Wiederholungslogik wird zur Ausgabenentscheidung, und ein aggressiver Backoff in einem wackligen Netz verdoppelt die Monatsrechnung, ohne dass es jemand merkt.
Wird nur ein gültiges Ergebnis berechnet, löst sich der Ärger größtenteils auf. Ein zweiter Anlauf, der nichts findet, kostet nichts, du kannst also knappe Timeouts fahren, ohne auf den Zähler zu schauen. Größtenteils, nicht vollständig: Ein Wiederholungsversuch, der dieselbe Adresse findet, ist trotzdem ein Treffer, und Enrow veröffentlicht keine Zusage, dass Dubletten erkannt werden. Führ deshalb selbst Buch über die Such-IDs, die noch offen sind. Wer nur für gültige Ergebnisse zahlt, wiederholt also billig, aber nicht kostenlos.
Zwei Dinge fehlen bei Enrow, und ich schreibe sie lieber hier hin, als dass du sie nachts um zwei entdeckst. X-RateLimit-*-Header gibt es nicht, und ein 429 kommt als nacktes {"message": "Too Many Requests"} an. RFC 6585 §4 macht Retry-After optional, Enrow lässt den Header weg, und die Doku sagt entsprechend, dass du den exponentiellen Backoff für die feste Obergrenze selbst einrichtest. Dazu kommt: 404 steht überhaupt nicht in der Liste der dokumentierten Statuscodes, dort stehen 400, 401, 402, 429 und 500. Ein Handler, der auf einen sauberen 404 für eine unbekannte oder abgelaufene Such-ID wartet, greift also nie.
So bindest du sie an
Die Authentifizierung läuft über einen API-Schlüssel im Header x-api-key. Kein OAuth-Ablauf, keine Bearer-Token, und die Doku sagt das auch ausdrücklich. Die Basis-URL lautet https://api.enrow.io.
Zu jedem POST gehört ein passender GET: /email/find/single, /email/find/bulk, /email/verify/single, /email/verify/bulk, /phone/single, /phone/bulk. Dazu kommt GET /account/info mit deinem Credit-Stand als einer einzigen Zahl und den hinterlegten Webhook-URLs.
Sechs Webhook-Ereignisse decken die Endpoints ab. Bei einer Einzelsuche enthält das Ereignis das vollständige Ergebnis, eine saubere Einzelsuch-Anbindung muss also nie selbst nachfragen. Bei einem Bulk-Lauf meldet das Ereignis lediglich, dass der Stapel durch ist; die Zeilen und die Credit-Abrechnung holst du über den passenden GET. Die Webhook-URL hinterlegst du global auf der Integrationsseite oder je Anfrage unter settings.webhook, ausschließlich über HTTPS, und sie muss mit 200 antworten.
Fehler, die du abfangen solltest: 401 bei falschem Schlüssel, 402 bei zu wenig Credits, 429 beim Rate-Limit. Achte auf den 402. Auf den Einzel-Endpoints kommt er als {reason, success}, im Bulk als schlichtes {message}, und daran scheitert ein gemeinsamer Fehler-Parser. Offizielle SDKs gibt es inzwischen, sieben Stück: JS/TypeScript, Python, PHP, Go, Java, Swift und Rust, laut docs.enrow.io/sdks/overview, abgerufen am 29. August 2026. Alle sieben sind im Early Access und werden aus dem GitHub-Quellcode statt über eine Paketregistry installiert; den Commit pinnst du also selbst, und die curl- und JavaScript-Beispiele aus der Doku bleiben der Rückfallweg. Die vollständige Spezifikation steht auf der Enrow-API-Seite, ein Schlüssel ist in etwa dreißig Sekunden da, ohne Verkaufsgespräch.
Sitzt am anderen Ende ein KI-Agent statt eines Dienstes, gibt es dafür einen offiziellen MCP-Server. Das Repo liegt als EnrowAPI/enrow-mcp auf GitHub, steht unter MIT-Lizenz und wird über npm installiert oder mit npx gestartet. Es stellt den Finder, den Verifier und die Telefonsuche als Tools bereit, nämlich find_email, find_emails_bulk, verify_email, find_phone und die zugehörigen Abholfunktionen; dokumentiert sind Claude Desktop, Cursor und Windsurf als Clients. So ermittelt ein Assistent einen Kontakt mitten im Gespräch, ohne dass jemand Anbindungscode schreibt.
Der Email Finder als Chrome-Extension: der Weg ohne Code
Viele von denen, die diese Daten brauchen, öffnen nie ein Terminal. Für sie ist eine Chrome-Extension zur E-Mail-Suche die richtige Oberfläche und keine API.
Enrows Extension arbeitet direkt auf einem LinkedIn- oder Sales-Navigator-Profil. Ein Klick schreibt den kompletten Datensatz nach HubSpot, Salesforce oder Pipedrive: Name, verifizierte E-Mail-Adresse, Direktnummer, Firma, LinkedIn-URL. Nicht eine kopierte Adresse, die jemand in ein Feld einfügt, sondern die ganze Kontaktkarte. Abgerechnet wird wie bei der API: ein Credit für eine verifizierte E-Mail-Adresse, 40 für eine verifizierte Nummer, und ohne Ergebnis kostet es nichts.
RevOps richtet den Ablauf ein, der Vertrieb arbeitet Profile ab. Dasselbe Credit-Guthaben, dieselbe Prüfung, zwei Oberflächen. Mehr dazu in E-Mail-Adressen über LinkedIn finden und in unserem Artikel zur Datenanreicherung in HubSpot.
Was diese API nicht für dich erledigt
Eine durchsuchbare Datenbank gibt es nicht. Wenn du Enrow nach „allen CTOs in Berlin bei Firmen ab 200 Mitarbeitern“ fragst, kommt nichts, weil es keine Liste gibt, die sich abfragen ließe. Der Finder braucht einen vollständigen Namen plus Firmendomain oder Firmenname. Die Telefonsuche braucht eine LinkedIn-URL.
Das ist ein bewusster Kompromiss, und der Grund dafür ist schnell erzählt. Datenbankanbieter aktualisieren in Zyklen, die man in Monaten misst, weshalb ein nennenswerter Teil dessen, was sie verkaufen, Leute beschreibt, die den Arbeitgeber längst gewechselt haben. Enrow ermittelt die Adresse erst im Moment der Anfrage, und daher kommt die Genauigkeit. Der Preis dafür ist, dass das Sourcing bei dir bleibt. Die Liste entsteht auf LinkedIn oder im Sales Navigator, danach geht sie an die API. Fürs Sequencing nimmst du Emelia, La Growth Machine oder lemlist.
Was ein verifizierter Kontakt kostet
Weil nur ein gefundenes Ergebnis berechnet wird, sind Listenpreis und echter Preis dieselbe Zahl. Start kostet 15 € im Monat für 1.000 Credits, das sind 0,015 € für eine gültige E-Mail-Adresse. Pro kostet 75 € für 10.000 Credits, also 0,0075 €. Scale beginnt bei 360 € für 50.000 Credits, und die Monatstarife reichen bis 200.000 Credits für 1.250 €. Stellst du diese oberste Stufe auf Jahreszahlung um, landest du bei rund 0,0056 € für eine Adresse, dem günstigsten Preis der ganzen Staffel. Eine Direktnummer kostet 40 Credits, im Pro-Tarif also 0,30 €. Eine Prüfung kostet 0,25 Credit, egal wie sie ausgeht.
Stell das einem Anbieter gegenüber, der je Versuch abrechnet, beim gleichen Monatsvolumen und auf derselben Grundlage, nicht Listenpreis gegen Listenpreis. Bei einer Trefferquote von 30 % kostet dich ein Tool, das 0,02 € für jede gestartete Suche berechnet, 0,067 € für jeden gefundenen Kontakt, und die Zeilen, die später bouncen, sind darin noch nicht enthalten. Nur diese Zahl gehört in eine Tabelle.
Eine Gebühr pro Nutzer gibt es nicht, auf Pro sind bis zu 10 Teammitglieder dabei, auf Scale beliebig viele, und übrige Credits werden übertragen, auf Pro bis zum Dreifachen deines Tarifs, auf Scale bis zum Sechsfachen. Der Gratis-Tarif umfasst 50 Credits jeden Monat, wiederkehrend, ohne Karte.
bereit, keine zeit mehr zu verschwenden?
Verbunden in Minuten.
Verifizierte Daten in Sekunden.
FAQ
Kostet eine erfolglose Suche über eine Email-Finder-API einen Credit?
Das hängt vom Anbieter ab, und es ist das Erste, was du nachschlagen solltest. Enrow, Anymail Finder und Findymail schreiben übereinstimmend, dass ihre Finder-Endpoints nur ein gefundenes Ergebnis berechnen; ZeroBounce verlangt für eine ungeklärte Suche nichts. Tools, die je Versuch abrechnen, kassieren schon die Anfrage. Nimmst du auf einer kalten B2B-Liste eine Trefferquote von 30 % an, kostet dich ein gefundener Kontakt mehr als das Dreifache des Preises je Suche. Dagegen fällt jeder Unterschied im Listenpreis kaum ins Gewicht.
Gibt es eine kostenlose Email-Finder-API?
Gratis-Tarife gibt es, dauerhaft kostenlose APIs bei großem Volumen in der Regel nicht, weil jede Suche den Anbieter echte SMTP-Arbeit kostet. Enrow gibt dir jeden Monat 50 Credits, wiederkehrend und ohne Karte, das sind 50 verifizierte E-Mail-Adressen oder 200 Prüfungen, dauerhaft, in der App, in der Chrome-Erweiterung und in KI-Assistenten. Zugang zur API bekommst du mit jedem Kauf: einem Tarif ab 15 € im Monat oder einem Credit-Paket ohne Abo.
Wie schnell sollte eine Email-Finder-API antworten?
Eine synchrone Suche, die länger als etwa fünf Sekunden braucht, macht überall Ärger, wo ein Mensch darauf wartet. Hunter lässt dich das über den Parameter max_duration zwischen 3 und 20 Sekunden einstellen und dokumentiert, dass eine längere Dauer genauere Daten hergibt. Bei Stapelarbeit zählt der Durchsatz, die Latenz je Zeile spielt dort keine Rolle. Einen p95 veröffentlicht in diesem Markt niemand, miss also selbst nach, mit deinem eigenen Volumen.
Kann ich eine Email-Finder-API im Bulk nutzen?
Ja, und ab ein paar hundert Zeilen solltest du das auch. Enrow nimmt bis zu 5.000 Kontakte je Bulk-Lauf beim Email Finder und 3.000 je Telefonlauf, die Ergebnisse kommen per Webhook oder über einen GET. Hunters v2-API hat gar keinen Bulk-Finder-Endpoint, dort läuft die Massenverarbeitung in der Oberfläche. Prüf also, ob es den Endpoint überhaupt gibt, bevor du deine Architektur darauf aufbaust.
Kann ich eine Suche nach einem Timeout gefahrlos wiederholen?
Technisch ja, aber rechne es vorher durch. POST ist nach RFC 9110 nicht idempotent, und der Header Idempotency-Key ist ein ausgelaufener IETF-Entwurf, den längst nicht jeder Anbieter unterstützt, weshalb ein zweiter Anlauf normalerweise ein zweiter abrechenbarer Vorgang ist. Wird nur ein gültiges Ergebnis berechnet, kostet ein Wiederholungsversuch ohne Treffer nichts, und knappe Timeouts werden bezahlbar. Führ trotzdem selbst Buch über die offenen Such-IDs.
Darf ich Kontakte anreichern, die ich nicht selbst erhoben habe?
In der EU stützt sich das auf Artikel 6 Abs. 1 lit. f DSGVO, das berechtigte Interesse, zusammen mit der Informationspflicht aus Artikel 14 und der Ausnahme nach Artikel 14 Abs. 5 lit. b, wenn die Benachrichtigung unverhältnismäßigen Aufwand bedeutet. Kaltakquise im B2B passt häufig in diesen Rahmen, die Bewertung dokumentierst aber du, und zwar mit einem Anwalt und nicht mit einem Blogbeitrag.
Prüf alle vier Kriterien an deiner eigenen Liste. Die Enrow-API steht dir mit jedem Kauf offen (ein Tarif ab 15 € im Monat oder ein Credit-Paket ohne Abo) und gibt dir den Schlüssel in etwa dreißig Sekunden. Die 50 Gratis-Credits im Monat, ohne Karte, nutzt du in der App, in der Chrome-Erweiterung und in KI-Assistenten.