À retenir Faire entrer un profil LinkedIn dans un CRM, c'est simple. Faire entrer une fiche à laquelle un commercial pourra écrire dès mardi, presque personne n'y arrive. HubSpot explique lui-même pourquoi ça coince. L'email y est « the primary unique identifier to avoid duplicate contacts », et sans lui, « each row of your import file will be imported as a new contact record ». Pipedrive, pour repérer un doublon, exige un nom plus un email, un téléphone ou une organisation commune. Confiez à l'une ou l'autre une fiche à moitié vide : elle n'a alors plus rien pour la rapprocher d'une fiche existante. Exigez donc quatre choses de tout outil qui fait passer LinkedIn dans le CRM : il écrit la fiche contact complète, il fait un create-or-update au lieu d'une insertion aveugle, il vérifie l'adresse avant de l'écrire, et sa couverture téléphonique inclut les numéros européens. Enrow assure ce passage directement depuis le profil, vers HubSpot, Salesforce ou Pipedrive : la fiche entière, vérifiée avant d'être écrite, en create-or-update. Une fiche que vous avez déjà est mise à jour, et seule une personne vraiment nouvelle est créée. Un crédit n'est débité que sur un résultat valide. En revanche, Enrow ne constitue pas votre liste : le sourcing se fait toujours sur LinkedIn.
Un commercial trouve la bonne personne sur LinkedIn. Bon poste, bonne boîte, bonne semaine. C'est ce jugement qui a de la valeur, et il lui faut une quarantaine de secondes.
Ensuite, le profil doit devenir une fiche, et tout le monde traite ce passage de LinkedIn au CRM comme de la simple plomberie. À tort : c'est à ce moment précis que ce jugement est conservé ou perdu, parce que ce qui arrive dans HubSpot, Salesforce ou Pipedrive n'est le plus souvent qu'un bout de fiche, sans aucun moyen de joindre la personne par email.
Trois méthodes sont couramment employées. Le commercial ressaisit les champs. Un connecteur synchronise le profil automatiquement. Ou quelqu'un prépare un CSV et l'importe. Les trois échouent, chacune à un endroit différent, et les dégâts s'accumulent, puisque c'est en réparant l'un qu'on déclenche le suivant.
Je passe en revue les trois, puis les critères qu'un outil doit remplir avant que je le laisse écrire dans un CRM auquel je tiens.
Méthode 1 : le commercial ressaisit tout
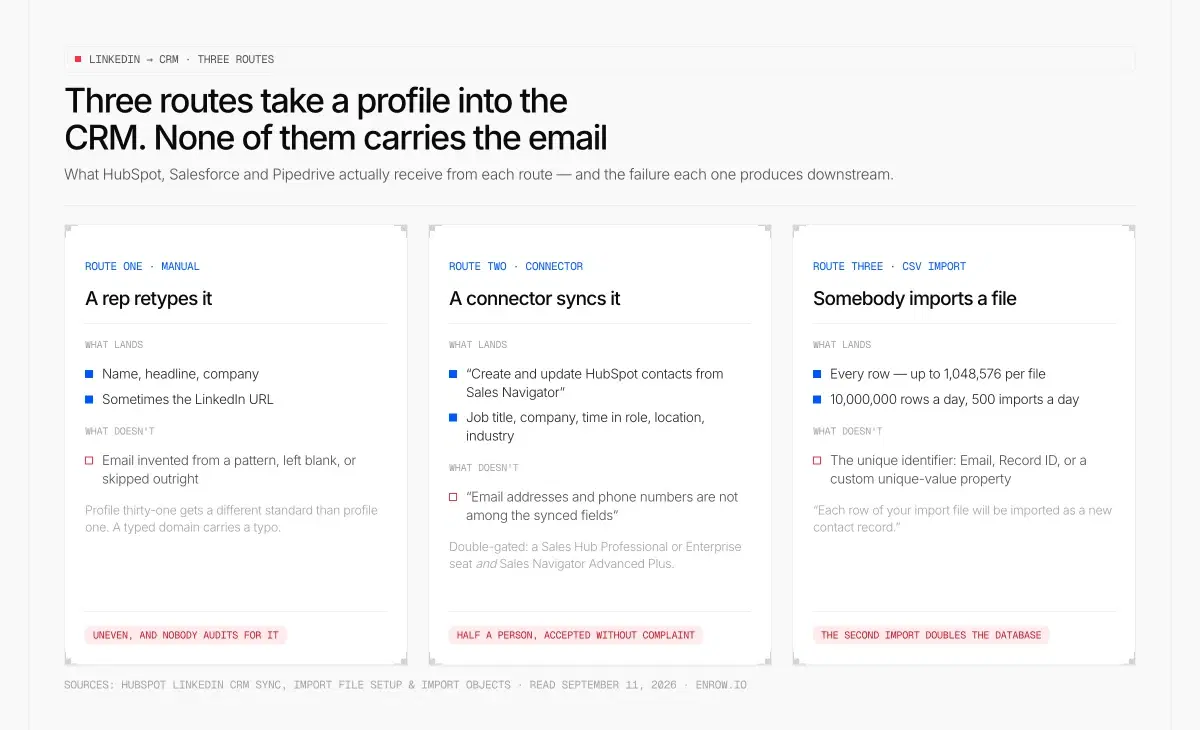
La colonne vertébrale de l'article en une image : chaque voie dépose une part différente du profil, et aucune des trois n'apporte l'adresse e-mail.
Ça marche. C'est justement ce qui gêne. Un humain qui lit un profil et saisit cinq champs dans un CRM produit une fiche sans le moindre défaut structurel.
Mais le résultat est inégal. Tout ce que le profil affiche est recopié : nom, titre, entreprise, parfois l'URL LinkedIn. L'email, c'est une autre affaire. Il est déduit du format de l'entreprise, ou laissé vide avec une note pour y revenir, ou carrément sauté parce que le commercial en est au trente et unième profil et que seuls les dix premiers ont eu droit au traitement complet.
C'est cette fatigue qui coûte vraiment, et elle n'apparaît dans aucun reporting. Votre CRM finit par contenir des fiches remplies avec deux niveaux d'exigence, selon l'heure à laquelle elles ont été créées. Personne ne contrôle ça.
Il y a un autre défaut, plus discret. Saisir un nom de domaine à la main introduit des fautes de frappe dans votre base à peu près aussi souvent que n'importe quelle recopie manuelle, et une faute dans le domaine donne une adresse syntaxiquement parfaite, mais qui ne fonctionne pas.
Méthode 2 : le connecteur qui n'écrit qu'une demi-fiche
Les outils de synchro s'acquittent bien de la création. La fiche apparaît, chaque champ est au bon endroit, le rattachement à l'entreprise est juste.
Mais ils ne transportent que ce que le profil affiche. Les intégrations officielles de LinkedIn en sont l'exemple le plus clair, parce qu'elles sont documentées publiquement et honnêtes sur leur périmètre.
Le LinkedIn CRM Sync de HubSpot compte parmi ses fonctionnalités « Create and update HubSpot contacts from Sales Navigator ». Un vrai create-and-update, de LinkedIn vers le CRM. Lisez le reste de la liste : import de contacts dans des listes Sales Navigator, enregistrement de l'activité Sales Navigator, inclusion ou exclusion des fiches associées dans la recherche, reporting d'attribution du chiffre d'affaires. Les adresses email et les numéros de téléphone n'apparaissent nulle part dans l'article parmi les champs synchronisés.
L'accès est en outre doublement verrouillé. La documentation de HubSpot exige « an assigned Sales Hub Professional or Enterprise seat » et un « LinkedIn Sales Navigator Advanced Plus plan ». L'intégration Sales Navigator, plus légère, est soumise au même double verrou et fait remonter le poste, l'entreprise, l'ancienneté dans le poste, la localisation, le secteur, les relations communes et l'activité récente. Du contexte utile sur une fiche que vous avez déjà. Pas de quoi joindre quelqu'un de nouveau.
L'extension Chrome Sales de HubSpot se trouve dans une situation comparable. Elle fonctionne dans Gmail, Google Calendar, Salesforce (avec une offre Professional ou Enterprise) et « All other websites » une fois l'option activée. L'article ne cite pas LinkedIn. Elle crée des contacts et des entreprises, enregistre les appels, inscrit des contacts dans des séquences, envoie des emails, prend des rendez-vous. La documentation ne lui prête aucune recherche d'email ni de téléphone.
Et voici pourquoi la demi-fiche a la vie si dure : tous les CRM l'acceptent sans broncher. L'API contacts de HubSpot précise que « when creating a new contact, it's required to include at least one of the following properties: email, firstname, or lastname ». L'endpoint Persons de Pipedrive n'exige que name. Le fragment entre donc sans erreur, se trie et se filtre correctement, et ressemble trait pour trait à une bonne fiche dans une vue en liste.
Citations tirées des articles LinkedIn CRM Sync et intégration Sales Navigator de HubSpot, de l'article sur l'extension Chrome Sales et de la référence de l'API contacts, ainsi que de l'endpoint Persons de Pipedrive. Toutes relevées le 11 septembre 2026.
Méthode 3 : le CSV qui finit en doublons
Le tableur a l'air de la solution sérieuse. On exporte ses leads LinkedIn d'un coup, on fait un seul import, et on passe à autre chose.
HubSpot énonce la règle en une phrase : « To update existing records and avoid duplicate records, your files must include a unique identifier property for each object. » Pour les contacts, cet identifiant est l'Email ou le Record ID, ou une propriété personnalisée à valeur unique. Pour les entreprises, c'est le nom de domaine ou le Record ID.
Puis il en donne la conséquence, tout aussi clairement. « If you don't include the Email property or other unique identifier in your import, each row of your import file will be imported as a new contact record. » Pour les entreprises, la règle est la même, avec le domaine à la place de l'email.
Le Record ID, quand vous en avez un, « supercede[s] any other unique identifiers included in the import », et « if a row in your file doesn't contain a value for Record ID, a new record will be created ».
Rien dans la plateforme ne vous en empêchera. Dès l'offre Starter, HubSpot accepte des fichiers jusqu'à 512 Mo, « up to 1,048,576 rows per file », « up to 10,000,000 rows per day », et 500 imports par jour. Même les outils gratuits autorisent 500 000 lignes par jour, réparties sur 50 imports. Ce n'est pas le plafond qui vous bloquera, c'est la colonne email de votre fichier.
C'est là que LinkedIn devient un problème à part entière, parce que c'est justement la colonne qu'il ne donne pas. Nous avons décortiqué l'export dans un article à part, comment exporter ses contacts LinkedIn ; pour faire court, l'adresse dépend des réglages de l'autre personne, et Sales Navigator ne propose aucun export de fichier.
Le premier import se passe donc bien. C'est le deuxième, le mois suivant, avec les mêmes noms et la même colonne manquante, qui remplit votre base de doublons.
Règles et limites d'import tirées des articles set up your import file et import objects de HubSpot, consultés le 11 septembre 2026.
Pourquoi un doublon coûte plus cher qu'un champ vide
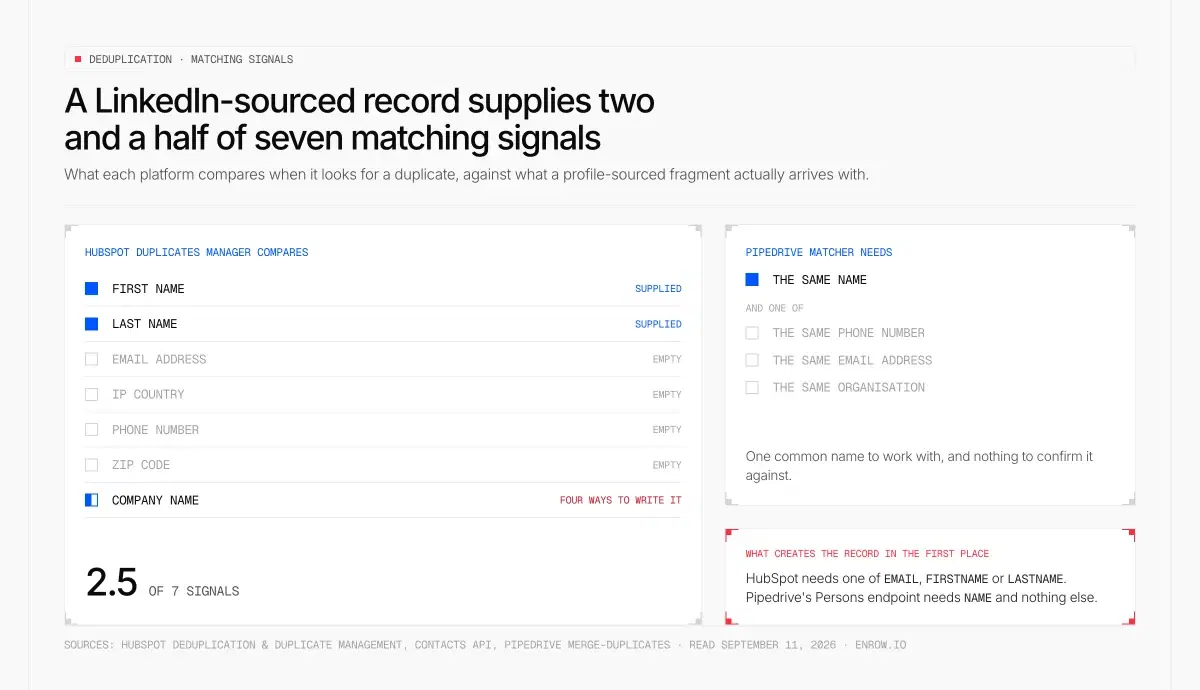
Deux signaux et demi sur sept : l'outil de dédoublonnage cherche un e-mail, un téléphone et un code postal que la fiche issue du profil n'a jamais fournis.
Un champ email vide se voit. Quelqu'un le remarque, quelqu'un le remplit. Un doublon, lui, est invisible par nature, et il vous coûte de cinq façons différentes.
Commençons par le pourquoi plutôt que par le combien. HubSpot dédoublonne automatiquement les contacts par l'adresse email (« automatically deduplicates contacts using email addresses ») et les entreprises par le nom de domaine. Affaires, tickets, produits et objets personnalisés ne se dédoublonnent qu'à la main, via le Record ID. Quand le gestionnaire de doublons de HubSpot cherche des paires, il compare « First Name, Last Name, Email address, IP country, Phone number, Zip Code, and Company Name ».
Comptez maintenant, dans cette liste, ce qu'apporte vraiment un fragment venu de LinkedIn. Un prénom, un nom, et un nom d'entreprise qui peut s'écrire de quatre manières selon qui l'a saisi. Deux signaux et demi sur sept.
Pipedrive arrive au même résultat par un autre chemin : il cherche les contacts qui ont « the same name – like Tom Smith – and one of the following: the same phone number, the same email address, or are part of the same organization ». Sans email, sans téléphone, sans organisation rattachée, il n'a plus qu'un nom courant pour faire le rapprochement.
Le reporting se fausse en premier. Deux fiches pour une personne, c'est un nombre de contacts faux, des taux de conversion calculés sur une base fausse, et des listes, construites sur un filtre de propriété, qui renvoient des chiffres que personne ne parvient à faire concorder.
L'historique d'activité se coupe en deux, et c'est pire que ça n'en a l'air. La documentation de fusion de HubSpot dit que « all timeline activities of both records included in the merge will appear on the new record ». Lisez-la à l'envers : tant que la fusion n'a pas eu lieu, l'historique reste éclaté. Une fiche contient les deux emails envoyés en mars, l'autre la réponse arrivée en avril, et le commercial qui ouvre l'une ou l'autre voit la moitié d'une conversation sans avoir la moindre raison de soupçonner qu'il en manque une partie.
Le lead scoring pâtit ensuite de cette coupure. Aucun éditeur de CRM ne documente ce point, alors prenez-le comme un raisonnement et non comme une citation : un score se calcule sur une fiche, à partir de l'activité de cette fiche. Répartissez le comportement d'une personne sur deux fiches, et il se peut qu'aucune des deux n'atteigne le seuil qui l'aurait fait attribuer à un commercial. Ou bien c'est la mauvaise fiche qui l'atteint, et le commercial ouvre le doublon vide.
Il y a aussi un coût direct, en argent, qui ne concerne toutefois que les contacts que vous avez définis comme contacts marketing. HubSpot : « if you exceed your current contact tier by adding marketing contacts, your account will be upgraded to the next contact tier. » Et redescendre n'est pas aussi simple, puisque « HubSpot doesn't downgrade contact tiers mid-term », si bien que « you are billed for the higher contact tier until your subscription's next renewal date, even if your marketing contact count later drops ».
Le nettoyage est le cinquième coût, et il dépend de votre offre. Le gestionnaire de doublons de HubSpot réclame un abonnement Professional ou Enterprise, fait remonter jusqu'à 10 000 paires en standard, 30 000 avec Data Hub Professional et 100 000 avec Data Hub Enterprise, et la gestion en masse exige un abonnement Data Hub. La fusion est à sens unique, selon les mots mêmes de HubSpot : « It's not possible to unmerge records. » Il y a même un plafond au nombre de fusions possibles : « You cannot merge records if they've been included in a combined total of 250+ merges. »
Le refus d'une paire suggérée, au moins, peut être annulé pendant 14 jours. C'est le seul retour en arrière possible dans tout le dispositif.
Déduplication, gestion des doublons et comportement de fusion tirés des articles deduplication, duplicate management et merge records de HubSpot ; facturation des contacts marketing dans l'article dédié ; critères de rapprochement de Pipedrive dans son article sur la fusion des doublons. Pages consultées le 11 septembre 2026.
Quatre critères pour juger une intégration LinkedIn–CRM
Tous les outils de cette catégorie vous diront qu'ils connectent LinkedIn à votre CRM. C'est vrai, tous le font. Les différences se cachent derrière le mot « connecter », et ces quatre questions les font apparaître en une minute environ.
1. Fiche complète ou fragment
Demandez quels champs arrivent dans le CRM, pas si l'outil synchronise. La liste que je veux voir : nom, email, téléphone, entreprise et URL LinkedIn, écrits en une seule opération.
Une fiche sans email, ce n'est pas 80 % d'une fiche. C'est une fiche sans identité, pour les raisons vues plus haut, et c'est précisément celle qui produira le doublon deux mois plus tard.
2. Create-or-update ou insertion aveugle
Les deux grandes plateformes proposent cette primitive, si bien qu'un outil qui ne s'en sert pas n'a aucune excuse technique.
HubSpot expose un endpoint de batch upsert sur les contacts. Son comportement, mot pour mot : « if the contacts already exist, they'll be updated and if the contacts don't exist, they'll be created. » Vous lui indiquez le champ de rapprochement avec le paramètre idProperty, en nommant soit email, soit une propriété d'identifiant unique personnalisée. Les opérations par lot sont plafonnées à 100 fiches à la fois.
Salesforce fait la même chose avec un PATCH sur un champ d'identifiant externe. Les cas documentés sont clairs : aucune correspondance, et « a new record is created according to the request body » ; une correspondance, et « the record is updated according to the request body » ; plusieurs correspondances, et « a 300 error is reported, and the record isn't created or updated ». Passer updateOnly=true désactive complètement la création.
Plusieurs outils du marché affichent désormais le create-or-update, et je ne vais pas prétendre le contraire. C'est la question suivante qui les départage : sur quel identifiant l'outil fait-il le rapprochement ? Un upsert fondé sur un email que vous n'avez pas n'est qu'une insertion sous un nom plus flatteur.
3. Vérification avant l'écriture ou nettoyage après
Vérifier après l'écriture, c'est de l'hygiène de données : une tâche qu'on planifie, une file d'attente qu'on ne vide jamais tout à fait. Vérifier avant l'écriture, c'est un filtre, et une fiche qui échoue au test n'entre jamais dans le CRM.
Au bout de six mois, les deux donnent des bases très différentes.
4. Téléphones, numéros européens compris
Une adresse fait entrer la fiche dans l'outil de campagnes que vous utilisez déjà. Un numéro de portable vous ouvre une conversation, et sur un compte cible c'est souvent le chemin le plus court.
Si votre marché inclut l'Europe, posez explicitement la question des numéros européens et celle de la base légale qui autorise à les détenir. Beaucoup d'outils conçus aux États-Unis ne les proposent tout simplement pas.
Comportement de l'upsert tiré de la référence de l'API contacts de HubSpot et de la documentation REST upsert de Salesforce, consultées le 11 septembre 2026.
De LinkedIn à HubSpot
HubSpot est le plus complet des trois sur tout, sauf sur le champ dont vous avez le plus besoin.
Son enrichissement natif peut nettement améliorer un contact. La liste complète des propriétés de contact qu'il sait remplir, mot pour mot : « City, Country, Country Code, Employment Role, Employment Seniority, Employment Sub Role, Enrichment opt-out, Enrichment opt-out timestamp, First Name, Job Title, Last Name, LinkedIn URL, State/Region, State/Region Code ». L'email n'y figure pas. Le téléphone du contact non plus : « Phone number » n'apparaît que parmi les propriétés de l'entreprise.
Et la condition d'accès boucle la boucle : « contacts must have a business email address. Personal addresses such as Gmail or Yahoo will not be enriched. » L'enrichissement améliore une fiche joignable. Il ne rend pas joignable une fiche qui ne l'est pas.
Deux points de fonctionnement à connaître avant de compter dessus. L'enrichissement automatique « fills properties containing blank or empty values » et « doesn't overwrite values set by a user or another system » : une valeur fausse déjà présente dans un champ y reste donc, alors que l'enrichissement manuel, lui, l'écrase. Lancé en masse depuis une vue en liste, l'enrichissement traite 100 fiches à la fois.
Côté coût, HubSpot facture le crédit 0,009 €, soit 9 € le pack de 1 000 crédits, et le catalogue précise que « unused credits do not roll over into the following month ». Ce que HubSpot ne publie nulle part, du moins dans ce que j'ai pu consulter, c'est le nombre de crédits que consomme une fiche enrichie. Autrement dit, tout coût par contact que vous verrez circuler pour l'enrichissement HubSpot a été estimé au doigt mouillé. Le fonctionnement du compteur de crédits, et tout ce qui y puise, est détaillé dans l'enrichissement de données HubSpot.
Pour l'écriture dans HubSpot (propriétés, upserts, et tout ce que l'API accepte sans sourciller), voyez l'API HubSpot et la donnée contact.
Périmètre et comportement de l'enrichissement tirés de l'article enrichissement de HubSpot ; prix du crédit dans le catalogue produits et services. Pages consultées le 11 septembre 2026.
De LinkedIn à Salesforce
Salesforce offre le meilleur create-or-update des trois, et c'est pourtant le moins utilisé.
L'upsert sur identifiant externe décrit plus haut est exactement ce qu'il faut pour écrire de LinkedIn vers Salesforce : on prend l'email comme clé, on laisse Salesforce décider s'il s'agit d'une création ou d'une mise à jour, et on voit dans l'erreur 300 non pas un obstacle, mais le signe que votre org contient déjà une ambiguïté à examiner.
Ce que Salesforce ne fait pas, c'est trouver l'email au départ. Son extension Chrome déplace des fiches au lieu d'aller chercher de la donnée contact, et ses mécanismes anti-doublons ne travaillent qu'avec les informations que la fiche contient à son arrivée. Nous avons traité ces deux points, ainsi que les plafonds des règles de rapprochement, dans l'extension Chrome Salesforce.
De LinkedIn à Pipedrive
Pipedrive est le plus permissif des trois sur ce qu'il accepte de stocker, et c'est un choix cohérent avec ce qu'il est : un outil de pipeline qui n'a jamais été vendu comme un outil de données.
name suffit à créer une Personne. Tout le reste est facultatif, l'adresse et le numéro compris. Pour repérer les doublons, Pipedrive exige ensuite un nom plus un email, un téléphone ou une organisation commune : précisément ce qu'une synchro LinkedIn n'apporte en général pas.
L'enrichissement, l'expiration des crédits et les restrictions selon l'offre sont détaillés dans l'intégration Pipedrive–LinkedIn.
Qui d'autre s'attaque à ce problème
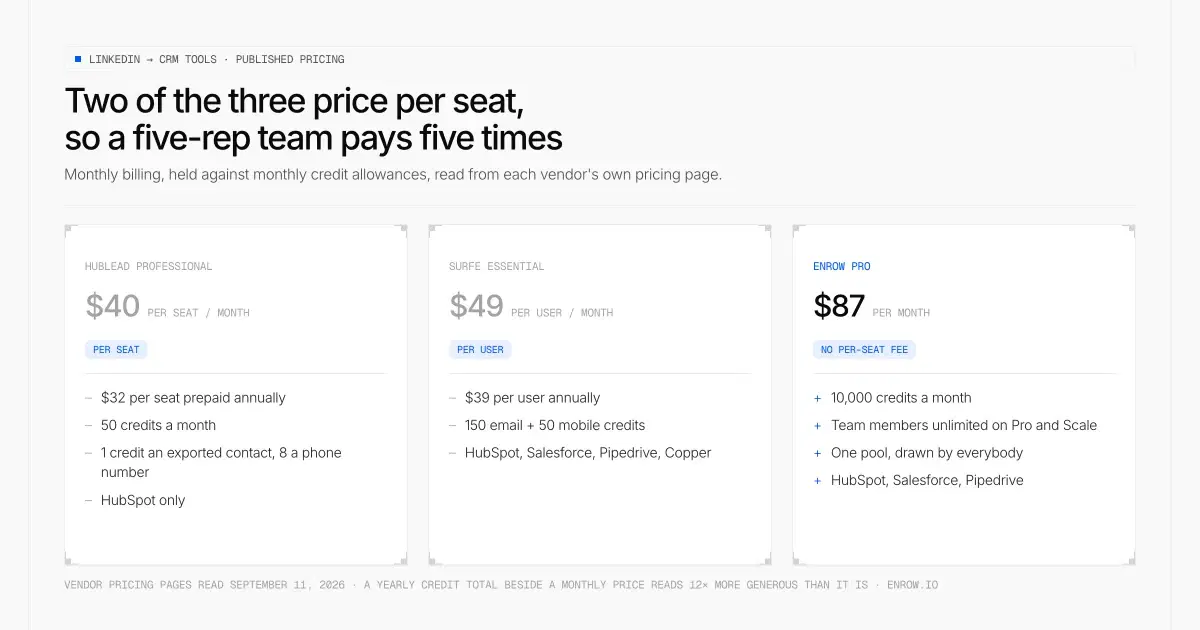
Deux des trois facturent au siège, donc le prix grimpe avec l'effectif ; la comparaison porte sur des prix et des crédits mensuels, comme l'article le recommande.
Deux outils sont nos concurrents directs sur ce terrain, et tous deux font bien ce pour quoi ils sont conçus. Je m'en tiens à ce qu'ils publient.
Hublead ne fonctionne qu'avec HubSpot. Starter est gratuit et ne comprend aucun crédit d'enrichissement. Professional est à 36 € par siège et par mois, 29 € avec l'année payée d'avance, et inclut 50 crédits par mois. Business est à 73 € et 58 €, pour 500 crédits par mois. Scale est à 127 € et 102 €, pour 2 000. D'après sa grille publiée, un contact exporté ou un enrichissement de liste HubSpot coûte 1 crédit, et l'accès à un numéro de téléphone, 8. (Tous ces montants sont convertis depuis ses tarifs en dollars.)
Surfe couvre davantage de CRM : HubSpot, Salesforce, Pipedrive et Copper. L'offre gratuite donne 20 recherches d'email et 5 de mobile par mois, avec un ajout au CRM en un clic, en quantité limitée. Essential est à 45 € par utilisateur et par mois, 35 € en annuel, avec 150 crédits email et 50 crédits mobile. Pro est à 81 € et 72 €, avec 1 000 crédits email et 100 crédits mobile, plus la synchro vers Salesloft, Outreach et lemlist. Enterprise est sur devis. (Montants convertis depuis sa grille en dollars.)
Les deux facturent au siège. C'est la différence structurelle à connaître avant de comparer les prix affichés, parce qu'une équipe de cinq commerciaux paie cinq fois le même outil.
Enrow ne facture pas au siège, et le nombre de membres d'équipe va jusqu'à 10 sur Pro, sans limite sur Scale. Tout le monde puise dans un seul compteur, donc le calcul reste le même pour un commercial ou pour neuf.
Une précaution si vous refaites la comparaison vous-même : comparez le mensuel au mensuel, l'annuel à l'annuel, et une dotation mensuelle de crédits à une dotation mensuelle. Une offre par siège qui affiche un total annuel de crédits à côté d'un prix mensuel paraît douze fois plus généreuse qu'elle ne l'est.
Je n'ai testé ni l'un ni l'autre en écriture sur un CRM en production, donc je ne me prononcerai pas sur la façon dont leur synchro gère les doublons. Posez-leur les quatre questions ci-dessus, et exigez qu'ils précisent l'identifiant sur lequel ils font le rapprochement.
Tarifs issus des pages de prix des deux éditeurs, consultées le 11 septembre 2026.
Ce qu'Enrow écrit dans la fiche
Enrow se place en dessous du CRM plutôt qu'à côté. Sur ce problème, il n'a qu'une tâche : prendre un profil LinkedIn ou Sales Navigator, trouver les vraies coordonnées de la personne, les vérifier, et remettre au CRM une fiche prête à l'emploi.
La liste des champs est publiée, alors je la cite plutôt que de la paraphraser. « Push any contact straight to HubSpot, Salesforce, or Pipedrive. Name, email, phone, company, LinkedIn URL — full record, zero manual entry. » Pas de propriété email vide. Pas de note pour y revenir plus tard, puisque personne n'y revient jamais.
L'écriture est un create-or-update. Si la personne est déjà dans votre CRM, sa fiche est mise à jour. Sinon, la fiche est créée. Vous n'aurez donc pas la version de mars d'une personne deux lignes au-dessus de sa version d'août, chacune avec la moitié de l'historique.
La vérification se fait avant l'écriture, pas après, donc rien n'entre dans le CRM à l'essai. Le détail de ce contrôle fait l'objet d'une section plus bas. La recherche, elle, se fait en direct : deux à cinq secondes, lancée au moment où vous la demandez, auprès du serveur mail et non dans une table que quelqu'un a compilée au printemps dernier.
Dans cette catégorie, le téléphone est généralement vendu à part. Enrow couvre les numéros de portable européens, ce que les outils conçus aux États-Unis ne tentent souvent même pas.
Et vous êtes facturé sur le résultat, jamais sur la tentative. Une recherche vide ne coûte rien, et une adresse qui échoue à la vérification non plus.
Citation de l'extension tirée de la page extension Chrome d'Enrow ; liste des intégrations natives sur enrow.io/fr/integrations. Toutes deux relevées le 11 septembre 2026.
Un champ rempli et un champ juste, ce n'est pas la même chose
Cette partie reste vraie quel que soit l'outil que vous choisirez, alors autant être précis.
Une adresse, c'est une affirmation sur une boîte mail précise, sur un serveur précis, et cette affirmation se périme sans prévenir personne. Un champ peut être rempli et faux de trois façons, et aucune ne se voit dans une vue en liste.
Le format était bon pour l'entreprise, mais pas pour cette personne. La plupart des organisations utilisent prenom.nom@, et puis il y a les deux Sarah Chen, le prestataire sur un autre domaine, et le dirigeant dont la boîte a été créée en 2014 selon une nomenclature que plus personne n'emploie.
La personne est partie. L'adresse enregistrée fonctionnait parfaitement en février. En mars, le contact a changé de poste, en avril sa boîte a été désactivée, et votre fiche affiche toujours une propriété email bien remplie, avec une coche verte à côté dans tous vos tableaux de bord.
Le domaine est en catch-all. Le serveur accepte toutes les adresses que vous lui présentez et ne confirme rien, donc un contrôle sommaire renvoie un résultat positif pour une adresse qui n'existe pas. Nous avons détaillé la mécanique dans qu'est-ce qu'un email catch-all.
La réponse d'Enrow aux trois est la même : plus de 10 vérifications distinctes avant qu'une adresse vous soit renvoyée. Plusieurs passes SMTP. Des sondes catch-all répétées depuis des serveurs situés dans des régions différentes, ce qu'il faut vraiment pour trancher sur un domaine qui dit oui à tout. Un catch-all ressort ici avec un verdict, pas avec une étiquette « risqué » qu'on vous laisse évaluer vous-même.
Mesurée sur mes propres fichiers, la part d'adresses trouvées tourne autour de 60 % et le taux de bounce reste sous 1 %. Ce sont des constats faits sur mes envois, pas des promesses pour les vôtres, et je préfère l'écrire ici plutôt que de vous le laisser découvrir dans un rapport de bounce.
Cela veut aussi dire que deux noms sur cinq ne donnent rien. Ceux-là ne vous coûtent rien non plus, et c'est tout l'intérêt de la facturation au résultat.
Ce que coûte la couche de données
La grille d'Enrow, en facturation mensuelle :
| Offre | Par mois | Crédits | Tout dépensé en emails | Tout dépensé en téléphones |
|---|---|---|---|---|
| Start | 15 € | 1 000 | 1 000 emails (0,015 € pièce) | 25 numéros de portable |
| Pro | 75 € | 10 000 | 10 000 emails (0,0075 €) | 250 numéros de portable |
| Scale | 360 € | 50 000 | 50 000 emails (0,0072 €) | 1 250 numéros de portable |
| Scale | 1 250 € | 200 000 | 200 000 emails (0,00625 €) | 5 000 numéros de portable |
Ces deux dernières colonnes sont les deux extrêmes d'un même budget, pas deux dotations qui s'additionnent. Il n'y a qu'un compteur. Un crédit paie un email, un quart de crédit revérifie une adresse que vous avez déjà, et quarante crédits paient un numéro de portable, soit environ 0,30 € sur Pro. Ce que vous dépensez en téléphones, vous le prenez sur votre budget email. C'est la façon honnête de le dire, et c'est pour ça que personne ne devrait enrichir toute une base en numéros.
L'engagement annuel donne 10 % de remise sur Pro et Scale. Start n'existe qu'en mensuel. Les crédits non utilisés sont reportés sur Pro et Scale.
Un crédit n'est débité que sur un résultat valide, jamais sur autre chose. Cette règle existait avant la plupart des acteurs du marché : Enrow a été le deuxième outil au monde à facturer l'email trouvé plutôt que la recherche lancée, et le reste de la catégorie a suivi.
L'offre gratuite se renouvelle. 50 crédits sont versés chaque mois, sans carte bancaire, et ce n'est pas un essai qui s'épuise.
En volume, le navigateur sort complètement du circuit. CSV, API, webhooks, ou un scénario dans Make, Zapier ou n8n. Claude et OpenAI figurent aussi parmi les intégrations natives, via le serveur MCP officiel sur github.com/EnrowAPI/enrow-mcp, qui place le finder et le verifier directement parmi les outils de l'assistant, au lieu de les cacher derrière un wrapper à maintenir vous-même. Ce montage est décrit dans agents IA commerciaux et MCP.
Ce qu'Enrow ne fait pas
Enrow ne constitue pas de listes de prospects. Il ne détient aucune base interrogeable et n'en ajoutera pas : une base est une photographie, et le marché de l'emploi continue de bouger une fois la photo prise. La recherche en temps réel, c'est tout le principe. Le revers de ce choix, c'est que quelqu'un d'autre doit vous fournir la personne, et ce quelqu'un s'appelle LinkedIn ou Sales Navigator.
Enrow n'envoie rien non plus. Il ne fera pas de séquences, ni maintenant ni plus tard. Ce métier revient d'abord à Emelia, puis à La Growth Machine et lemlist ; la fiche vérifiée doit arriver dans celui des trois que vous payez déjà.
Pas de données technographiques non plus. Ce qu'Enrow sait d'une entreprise correspond à peu près à ce que LinkedIn en montre, et rien de plus.
Enfin, la liste des CRM en compte bien trois, pas trente. Aujourd'hui, HubSpot, Salesforce et Pipedrive sont intégrés nativement. Attio, Close CRM et Microsoft Dynamics passent par des connecteurs tiers, pas par une intégration native, et je ne vais pas le présenter autrement sur une page consacrée à l'écriture de fiches propres.
Plus de 5 000 entreprises utilisent Enrow. Un périmètre étroit, par choix, et qui le restera.
Comment j'ai vérifié tout ça
Chaque affirmation de cette page sur HubSpot vient d'une page publiée par HubSpot, consultée le 11 septembre 2026 : la référence de l'API contacts, les articles sur la déduplication, la gestion des doublons et la fusion, les deux articles sur l'import, l'article sur l'enrichissement, celui sur la facturation des contacts marketing, celui sur l'extension Chrome Sales, les deux articles sur l'intégration LinkedIn et le catalogue juridique des produits et services. Le comportement de l'upsert Salesforce vient de sa documentation développeur REST API. Les champs obligatoires de Pipedrive viennent de sa documentation développeur, et ses critères de rapprochement de sa base de connaissances.
Quand un chiffre n'est pas publié, cette page le dit au lieu de l'estimer. Ça vaut pour le coût en crédits d'une fiche enrichie chez HubSpot, pour les champs obligatoires d'un Lead Salesforce, et pour toute statistique sur la fréquence à laquelle une synchro produit une fiche injoignable. Aucun éditeur n'en publie, et je ne vais pas en inventer.
Les chiffres d'Enrow viennent d'enrow.io, consulté le 11 septembre 2026.
Prenez un profil que vous avez déjà jugé intéressant. Envoyez-le dans le CRM par la méthode que vous utilisez aujourd'hui, puis ouvrez la fiche et cherchez l'email. S'il est vide, ou s'il est là sans que vous puissiez dire s'il fonctionne, vous avez tout le problème sous les yeux, sur un seul écran. Enrow vous donne 50 crédits par mois, récurrents, sans carte bancaire. De quoi faire passer le même profil par l'autre voie et comparer ce qui arrive dans le CRM.
utilisateur illimité
Prêt à passer à la vitesse supérieure
FAQ
Comment connecter LinkedIn à mon CRM ?
Il y a trois méthodes. Un commercial recopie les champs à la main. Un connecteur de synchro ou une extension Chrome écrit automatiquement le profil dans le CRM. Ou vous préparez un CSV et vous l'importez. Jugez-les sur ce qui arrive dans la fiche, pas sur la réussite de la connexion : la fiche contient-elle une adresse vérifiée, l'écriture met-elle à jour la fiche existante au lieu d'ajouter une ligne, et le téléphone couvre-t-il vos marchés ? Un connecteur qui n'apporte rien de plus que ce que LinkedIn vous montrait déjà a déplacé un fragment, pas un contact.
Peut-on relier son CRM à LinkedIn Sales Navigator ?
Oui, mais l'accès est verrouillé des deux côtés. La documentation de HubSpot exige un siège Sales Hub Professional ou Enterprise attribué, plus une offre LinkedIn Sales Navigator Advanced Plus, aussi bien pour l'intégration Sales Navigator que pour le CRM Sync. Ce qui se synchronise, c'est du contexte et de l'activité : poste, entreprise, ancienneté dans le poste, localisation, secteur, relations communes, activité récente, plus les informations renvoyées vers le CRM. Les adresses email et les numéros de téléphone ne figurent pas parmi les champs synchronisés.
Quel CRM a la meilleure intégration LinkedIn ?
Ce n'est pas l'intégration qui fait la différence. Les trois grands CRM acceptent un profil LinkedIn comme fiche, et tous trois enregistreront aussi une fiche dont le contact est injoignable. HubSpot est le plus strict sur l'identité, puisque l'email est son identifiant unique principal pour la déduplication. Salesforce a la primitive create-or-update la plus propre, via l'upsert sur un identifiant externe. Pipedrive est le plus permissif, un nom lui suffit. Choisissez votre CRM en fonction du reste de vos outils, puis traitez la couche de données à part : c'est elle qui fait la valeur des fiches. C'est précisément là qu'intervient Enrow.
Pourquoi mon CRM se remplit-il de doublons ?
Parce que l'écriture ne disposait d'aucun identifiant unique pour faire le rapprochement. HubSpot le dit franchement : sans la propriété Email ni aucun autre identifiant unique, « each row of your import file will be imported as a new contact record ». Son gestionnaire de doublons compare First Name, Last Name, Email address, IP country, Phone number, Zip Code et Company Name, et une fiche venue de LinkedIn n'en fournit presque aucun. Pipedrive exige un nom identique, plus un email, un téléphone ou une organisation commune. Mettez un email vérifié sur la fiche dès sa création, et toute cette catégorie de problèmes disparaît.
Peut-on exporter gratuitement ses leads LinkedIn vers un CRM ?
En partie. L'archive des relations LinkedIn s'exporte, mais la colonne email ne se remplit que pour les personnes dont les réglages l'autorisent, et Sales Navigator ne propose aucun export CSV ni XLS. Ces deux points sont traités dans l'article « comment exporter ses contacts LinkedIn ». Côté enrichissement, l'offre gratuite d'Enrow donne 50 crédits renouvelés chaque mois, sans carte bancaire, de quoi tester tout le processus sur une vraie liste avant de payer quoi que ce soit.
Combien coûte un contact joignable déposé dans un CRM ?
La moitié qui revient à Enrow est publiée en totalité. Un email valide coûte 0,015 € sur Start, 0,0075 € sur Pro et 0,0072 € sur Scale ; un numéro de portable valide, quel que soit son pays, revient à environ 0,30 € sur Pro, et il puise dans le même compteur de crédits que les emails, pas dans une enveloppe séparée. Une recherche vide n'est pas facturée. L'autre moitié, côté CRM, est impossible à calculer honnêtement : HubSpot affiche 0,009 € le crédit mais ne publie pas combien de crédits consomme l'enrichissement d'une fiche, et Pipedrive publie des volumes de crédits sans prix unitaire.
Une synchro LinkedIn–CRM récupère-t-elle les adresses email ?
En général non, et c'est dans la documentation qu'il faut le vérifier. Le LinkedIn CRM Sync de HubSpot compte la création et la mise à jour de contacts parmi ses fonctionnalités, sans jamais citer l'email ni le téléphone parmi les champs. L'enrichissement natif de HubSpot, lui, ne sait pas remplir l'email d'un contact : sa liste de propriétés enrichissables s'arrête au nom, au poste, à l'ancienneté, à la localisation et à l'URL LinkedIn, et il ne fonctionne que si le contact a déjà une adresse professionnelle. Si aucun maillon de la chaîne ne trouve ni ne vérifie d'adresse, aucun n'en mettra une sur la fiche.