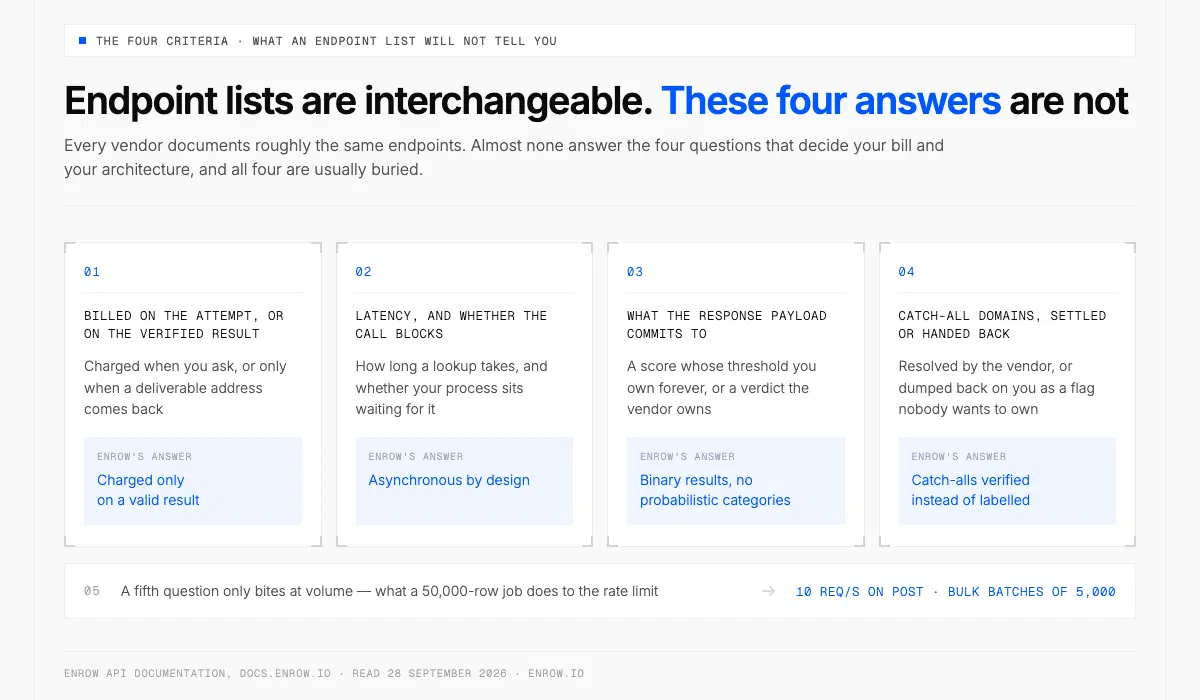
Todos os fornecedores documentam os mesmos endpoints; as quatro respostas que decidem a fatura, quase nenhum as publica.
O essencial Uma API de email finder parte de uma pessoa que já identificou — em regra, um nome e uma empresa — e devolve o endereço profissional verificado. Os endpoints documentados são praticamente os mesmos de fornecedor para fornecedor. Quase nenhum responde, porém, às quatro perguntas que decidem a fatura do mês e a arquitetura do seu sistema: cobra-se a tentativa ou só o resultado verificado, quanto demora uma pesquisa e se bloqueia o processo, o que a resposta garante de facto, e se um domínio catch-all sai resolvido ou lhe fica nas mãos. Há uma quinta pergunta que só se põe quando o volume cresce — como se porta o limite de pedidos perante um trabalho de 50 000 linhas. A título de referência, as respostas da Enrow: só debita crédito quando o resultado é válido, todos os endpoints são assíncronos, os catch-all são verificados em vez de etiquetados, 10 pedidos por segundo nos POST, lotes de 5 000 linhas. Leia as condições de cobrança antes da lista de funcionalidades. Pesam mais no custo real do que o preço de tabela.
Uma API de email finder é um endpoint HTTP que encontra o endereço de email profissional de uma pessoa. Envia-se um nome e uma empresa. Recebe-se um endereço e uma indicação sobre se ele existe de facto.
Antes de mais, um esclarecimento, porque quem procura «email API» encontra sobretudo outra coisa: fornecedores de envio e serviços de email transacional. Esses tratam de expedir mensagens. Uma API de email finder liga uma pessoa ao seu endereço antes de haver qualquer mensagem.
Os quatro critérios que se seguem nasceram da construção de uma destas APIs e da leitura, pelo caminho, da documentação de uma dúzia de concorrentes. As listas de endpoints são intermutáveis. O modelo de cobrança, os compromissos de latência, o formato da resposta e o tratamento dos catch-all não o são, e os quatro estão quase sempre enterrados no fundo da página. O limite dos lotes também conta, mas só quando o volume é a sério; por isso tem secção própria, logo depois destes.
1. Cobrança por tentativa ou por resultado verificado
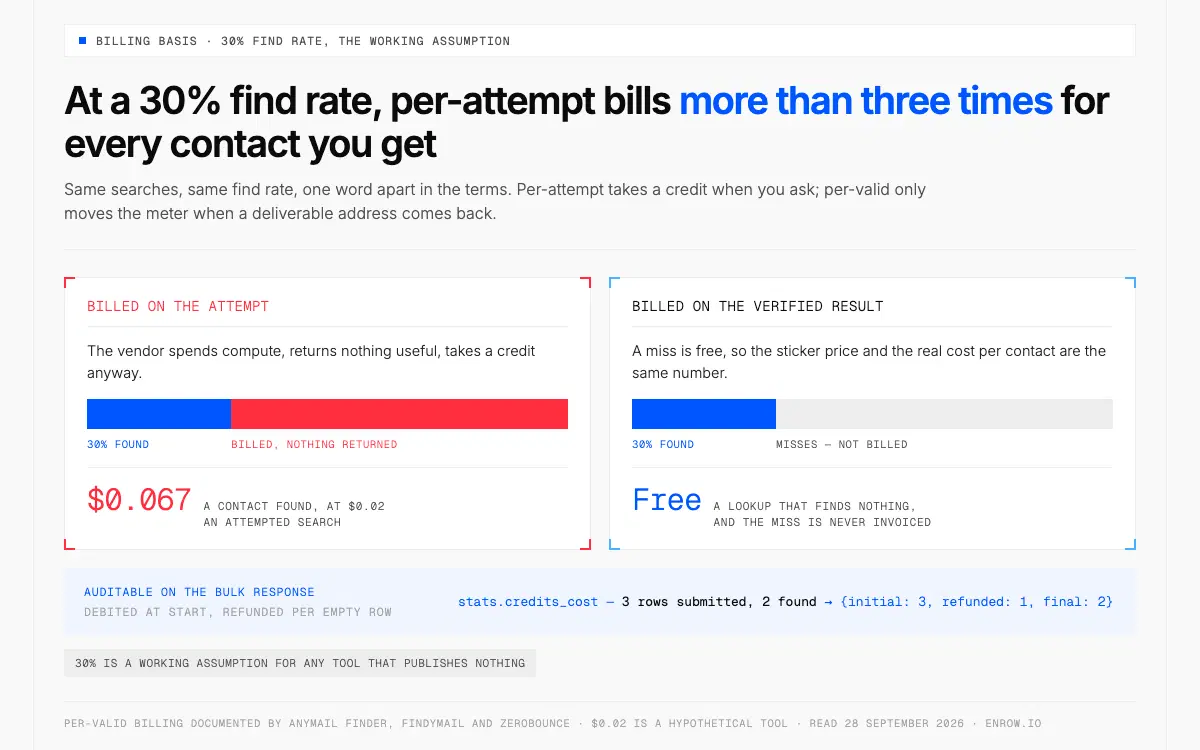
Quando se pagam as falhas, cada contacto encontrado custa mais de três vezes o preço da pesquisa.
É aqui que tudo se decide, e é precisamente o ponto que a maior parte das páginas de preços omite.
Há dois modelos. Por tentativa: paga-se quando se pergunta. O fornecedor gasta capacidade de processamento, não encontra nada de útil e fica com o crédito à mesma. Por resultado válido: uma falha não custa nada, e só se debita crédito quando a pesquisa devolve um endereço que chega ao destino.
A diferença está longe de ser um pormenor. Em listas B2B frias, as taxas de cobertura ficam bem abaixo de metade, e 30% é a hipótese de trabalho razoável para qualquer ferramenta que não publique nada. Com 30%, quem cobra por tentativa faz-lhe pagar mais de três vezes cada contacto que acaba por obter. Depois, uma parte do que foi encontrado faz bounce, e também isso já estava pago.
Alguns fornecedores põem esta cláusula por escrito, o que já vale alguma coisa. O Anymail Finder só debita crédito depois de o endereço estar verificado. No Findymail é igual: um crédito por endereço encontrado. E o ZeroBounce cobra as pesquisas bem-sucedidas e não cobra nada quando o resultado é «unknown».
Os endpoints de pesquisa da Enrow funcionam da mesma maneira, e a resposta em lote torna a contabilidade auditável. Um GET de lote devolve stats.credits_cost em três números: initial, refunded, final. Os créditos saem do saldo quando o lote arranca e são repostos linha vazia a linha vazia. O exemplo da documentação submete 3 linhas, encontra 2 e fecha em {initial: 3, refunded: 1, final: 2}. Dá para conferir a despesa de um mês com as linhas encontradas sem abrir um pedido de suporte.
Uma ressalva, porque aqui a regra é a inversa. O Email Verifier da Enrow cobra por controlo, 0,25 crédito, e não por resultado válido. Mesmo que lhe dê endereços mortos, paga 0,25 por linha. Na pesquisa, paga-se por resultado válido; na verificação, por controlo feito. Convém saber isto antes de mandar um trabalho de limpeza pelo endpoint errado.
2. Latência: a chamada bloqueia ou não o processo
Há duas filosofias de conceção, e nenhuma delas está errada.
Algumas APIs respondem de forma síncrona. O Anymail Finder diz que a maior parte das pesquisas individuais responde em cerca de três segundos. O Hunter pôs essa escolha num parâmetro: max_duration, entre 3 e 20 segundos, 10 por omissão, com a documentação a explicar que uma duração maior lhe permite afinar os resultados e devolver dados mais exatos. É uma opção invulgarmente honesta. A precisão custa milissegundos, e o Hunter deixa-o decidir quantos quer gastar.
A Enrow foi pelo caminho oposto. Todos os endpoints são assíncronos. Um POST a /email/find/single devolve de imediato um identificador de pesquisa, e o resultado chega por webhook ou por consulta do GET correspondente. A documentação explica que a escolha é deliberada: com grandes volumes, quem faz a chamada nunca fica bloqueado. Enquanto a pesquisa decorre, o GET responde {"qualification": "ongoing"}.
A verificação em si resolve-se em segundos. Só que o processo não fica ali à espera dela, e o código que conta com o endereço na resposta ao POST não o vai encontrar lá.
Qual dos dois lhe serve depende do ponto do processo em que a pesquisa é feita. Num formulário, com uma pessoa a olhar para o ecrã, uma chamada síncrona de três segundos não incomoda ninguém. Num trabalho noturno sobre 40 000 linhas, uma chamada que bloqueia é um problema anunciado. O RFC 9110 §15.3.3 trata do segundo caso: um 202 Accepted significa que o pedido foi aceite para processamento, mas que este ainda não terminou.
O que ninguém publica é um p95. Nem a Enrow, nem os fornecedores citados acima. O marketing diz «em segundos» e não há quem se comprometa com um percentil. Meça-o com o seu próprio volume antes de construir o que quer que seja com base num número tirado de uma página comercial.
3. O que a resposta lhe diz de facto
É aqui que o mercado se divide em duas escolas, e escolher a errada custa semanas de engenharia.
A primeira escola entrega-lhe a incerteza. O Email Finder do Hunter devolve um score de 0 a 100, um booleano accept_all, um objeto verification com o estado valid, accept_all ou unknown, e até vinte entradas em sources com a página de onde veio cada menção e as datas extracted_on e last_seen_on. A documentação do Hunter é franca quanto ao score num domínio accept-all: estima a probabilidade de o endereço ser válido. O ZeroBounce faz o mesmo numa escala menos fina, com email_confidence em HIGH, MEDIUM ou LOW e um de nove valores em failure_reason.
Dá jeito a quem está a construir a sua própria camada de pontuação. O array sources é uma verdadeira ferramenta de investigação.
A segunda escola resolve a questão e entrega um veredicto. A pesquisa da Enrow devolve qualification com o valor valid ou invalid, e ongoing enquanto a pesquisa está a decorrer. A documentação di-lo sem rodeios: resultados binários, sem categorias probabilísticas. Junto vêm o email, um bloco info com o domínio e o nome da empresa, o nome próprio e o apelido, e o objeto custom que foi enviado no pedido.
A pergunta a fazer não é qual das respostas é mais rica. É quem fica com o limiar nas mãos. Se a API devolve uma pontuação de 0 a 100 e accept_all: true, o limiar é seu para sempre — e cada comercial que se queixa de um bounce está a queixar-se de um número escolhido por si. Se a API devolve valid ou invalid, o limiar é do fornecedor, e é a ele que se pedem contas.
O objeto custom poupa toda uma categoria de código de ligação. O que lá puser, por pedido ou por linha num lote, aparece intacto na resposta do GET e no webhook. Identificador interno do contacto, etiqueta de campanha, ID do registo no CRM: qualquer chave que o seu processo use. Dispensa tabelas de correspondência.
4. Domínios catch-all: resolvidos ou deixados nas suas mãos
Um domínio accept-all responde que sim a qualquer endereço que se teste nele. Caixa real, gralha, disparate completo — tudo aceite. Não é falha de nenhum fornecedor, vem do próprio protocolo. O RFC 5321 §3.5.3 prevê-o: há circunstâncias em que um endereço parece válido mas não pode ser razoavelmente verificado em tempo real, e o servidor deve então devolver um 252. E o §3.3 assinala que alguns servidores só verificam o destinatário quando chega o corpo da mensagem, ou seja, um endereço aceite ainda pode fazer bounce mais tarde.
Um único teste SMTP não resolve isto. É uma limitação do protocolo, não uma falha das ferramentas.
A maior parte das APIs passa-lhe o problema. O verificador do Hunter devolve accept_all, e a própria documentação avisa que, quando o servidor SMTP aceita tudo, as verificações SMTP podem dar falsos positivos. É honesto, mas deixa-lhe um monte de linhas de que ninguém quer tratar.
Não deite fora esse monte. As listas B2B estão cheias, precisamente, das empresas com mais probabilidade de usar accept-all, e apagar tudo o que traz essa etiqueta é mandar para o lixo decisores bem reais juntamente com as linhas mortas.
Em vez de os etiquetar, a Enrow resolve os catch-all de forma determinista: várias passagens SMTP a partir de servidores em regiões diferentes, cruzadas com endereços de controlo deliberadamente falsos no mesmo domínio, no conjunto das mais de 10 verificações por trás de cada resultado. Um catch-all resolvido sai como valid e é cobrado como encontrado. O que não se consegue resolver sai como invalid e não custa nada. A verificação dos catch-all está incluída no preço do crédito; não é um extra. A taxa de bounce observada fica abaixo de 1% — é uma média de envios reais, não uma garantia. Os pormenores técnicos estão em o que é um email catch-all; o impacto no envio, no artigo sobre a taxa de bounce.
Endpoints de pesquisa em massa e limites de pedidos
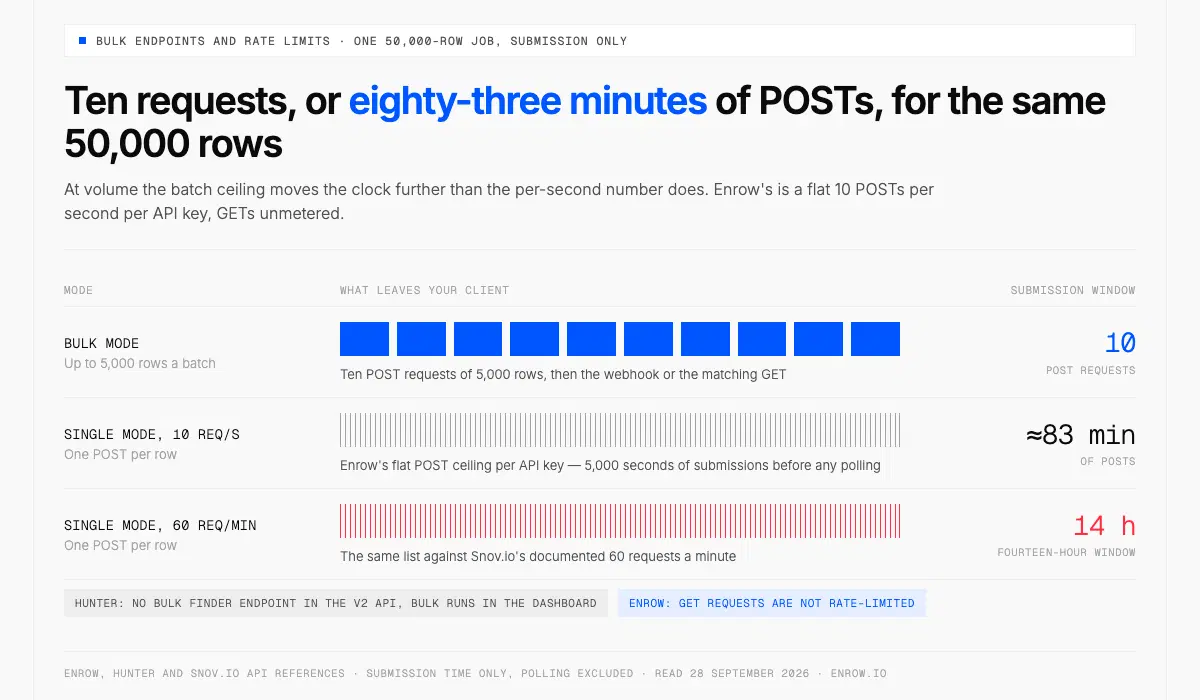
Com volume, o que manda é o tamanho do lote, não o limite por segundo: dez pedidos face a uns 83 minutos de POST.
Um email finder em massa é um endpoint que aceita uma lista inteira de contactos num só pedido e devolve os endereços verificados num trabalho em lote, em vez de uma chamada HTTP por pessoa. É a diferença entre um processo que termina durante a noite e outro que nunca chega ao fim.
O tamanho máximo dos lotes e os limites de pedidos variam muito, e influenciam-se mutuamente.
| Fornecedor | Pesquisa em massa | Limite de pedidos publicado |
|---|---|---|
| Enrow | Até 5 000 linhas por lote (3 000 para telefones) | 10 pedidos/s em todos os endpoints POST; GET sem limite |
| Hunter | Sem endpoint de pesquisa em massa na API v2; o processamento em massa faz-se no painel de controlo | Email Finder 15 pedidos/s e 500 por minuto; verificador 10 pedidos/s e 300 por minuto |
| Anymail Finder | Até 100 000 linhas por trabalho, resultados por webhook (afirmação do fornecedor) | Sem limites diários nem horários (afirmação do fornecedor, sem SLA publicado) |
| Snov.io | A pesquisa em massa é uma funcionalidade do produto; a referência da API não descreve nenhum endpoint de lote | 60 pedidos por minuto |
Faça as contas a um trabalho de 50 000 linhas. Em modo individual, com um limite de 10 pedidos por segundo, são 5 000 segundos só a submeter — uns 83 minutos de POST antes sequer de ir buscar resultados. Em lote, o mesmo trabalho cabe em dez pedidos. Com os 60 por minuto documentados no Snov, o modo individual estende-se por catorze horas.
Com volume, portanto, o tamanho do lote pesa mais do que o limite por segundo. O limite da Enrow é fixo: 10 POST por segundo por chave de API, com os GET fora da contagem e a possibilidade de pedir um aumento através de api@enrow.io. Acima disso não há nenhum valor publicado: não conte com ele na arquitetura.
Repetições, idempotência e porque é o modelo de cobrança que decide a estratégia
O POST não é idempotente. O RFC 9110 §9.2.2 diz que um cliente pode repetir um pedido quando não chega resposta, mas que, para efeitos de repetição, o pedido deve ser idempotente — e um POST de pesquisa não o é. Repetir um pedido que esgotou o tempo limite gera um segundo evento a pagar, a não ser que o fornecedor faça a deduplicação.
O cabeçalho a que toda a gente recorre, Idempotency-Key, não é uma norma. É um rascunho do IETF, draft-ietf-httpapi-idempotency-key-header, caducado na revisão 07. O suporte varia de fornecedor para fornecedor e tem falhas. O Hunter implementa-o com jeito — TTL de 24 horas, impressão digital do corpo do pedido, quatro códigos de erro distintos —, mas só nos endpoints de sequências e de mensagens. No Email Finder, não.
Com cobrança por tentativa, isto torna-se um problema a sério. A lógica de repetição passa a ser uma decisão de despesa, e uma política agressiva de repetições numa rede instável duplica a conta do mês sem que ninguém dê por isso.
Com cobrança por resultado válido, o problema quase desaparece. Uma pesquisa repetida que não encontra nada não custa nada, o que permite ser agressivo nos tempos limite sem estar de olho na conta. Quase, mas não totalmente: uma repetição que encontra o mesmo endereço continua a ser um resultado encontrado, e a Enrow não publica nenhuma garantia de deduplicação. Guarde o seu próprio registo dos identificadores de pesquisa em curso. A cobrança por resultado válido torna as repetições baratas, não gratuitas.
Mais duas coisas que a Enrow não lhe dá, ditas às claras, porque de outro modo só as descobre às duas da manhã. Não há cabeçalhos X-RateLimit-*, e um 429 chega como um simples {"message": "Too Many Requests"}. O RFC 6585 §4 torna o Retry-After opcional e a Enrow não o envia; a documentação pede, por isso, que seja quem integra a implementar o backoff exponencial face ao limite fixo. E o 404 nem sequer consta dos códigos de estado documentados — a lista é 400, 401, 402, 429 e 500 —, o que faz com que um tratamento de erros que conte com um 404 claro para um identificador de pesquisa desconhecido ou expirado nunca chegue a ser acionado.
Pôr isto a funcionar
A autenticação faz-se com uma chave de API no cabeçalho x-api-key. Sem fluxo OAuth nem bearer tokens, e a documentação di-lo com todas as letras. O URL base é https://api.enrow.io.
Cada POST tem o GET correspondente: /email/find/single, /email/find/bulk, /email/verify/single, /email/verify/bulk, /phone/single, /phone/bulk, mais um GET /account/info que devolve o saldo de créditos disponível, num único número, e os URL de webhook configurados.
Seis eventos de webhook cobrem os endpoints. Os eventos de pesquisa individual trazem o resultado completo, portanto uma integração individual bem feita nunca precisa de andar a consultar o GET. Os eventos de lote limitam-se a avisar que o lote terminou; as linhas e a contabilidade dos créditos vêm do GET correspondente. O URL do webhook define-se globalmente, na página de integrações, ou pedido a pedido, em settings.webhook; só aceita HTTPS e tem de responder 200.
Erros que vale a pena tratar: 401 para chave errada, 402 para créditos insuficientes, 429 para o limite de pedidos. Atenção ao 402, que traz {reason, success} nos endpoints individuais e a forma simples {message} nos de lote, o que quebra qualquer analisador de erros partilhado. Já existem SDK oficiais em sete linguagens (JS/TypeScript, Python, PHP, Go, Java, Swift e Rust), segundo docs.enrow.io/sdks/overview, consultado a 29 de agosto de 2026. Os sete estão em acesso antecipado e instalam-se a partir do código no GitHub, e não de um repositório de pacotes, ou seja, é preciso fixar um commit à mão, e os exemplos em curl e em JavaScript da documentação continuam a ser a alternativa de recurso. A especificação completa está na página da API da Enrow; obter uma chave demora uns trinta segundos e não exige nenhuma chamada comercial.
Se quem chama é um agente de IA e não um serviço, há um servidor MCP oficial: repositório EnrowAPI/enrow-mcp no GitHub, licença MIT, instalado por npm ou executado com npx. Expõe a pesquisa de emails, a verificação e a procura de telefone como ferramentas — find_email, find_emails_bulk, verify_email, find_phone e as funções correspondentes que vão buscar os resultados. Os clientes documentados são o Claude Desktop, o Cursor e o Windsurf. Um assistente encontra os dados de um contacto a meio de uma conversa, sem uma única linha de código de integração.
A extensão Chrome de email finder: o caminho sem código
Muitas das pessoas que precisam destes dados nunca vão abrir um terminal. Para elas, a ferramenta certa é uma extensão Chrome de email finder, e não uma API.
A extensão da Enrow funciona a partir de um perfil do LinkedIn ou do Sales Navigator. Com um clique, o registo completo fica gravado no HubSpot, no Salesforce ou no Pipedrive: nome, email verificado, telemóvel direto, empresa, URL do LinkedIn. Não é um endereço copiado e colado num campo, é a ficha de contacto inteira. A cobrança é igual à da API: um crédito por email verificado, 40 por telemóvel verificado, nada quando não há resultado.
A equipa de RevOps monta o processo; os comerciais trabalham perfil a perfil. O mesmo saldo de créditos, a mesma verificação, duas formas de acesso. Mais pormenores no guia para encontrar emails no LinkedIn e no artigo sobre o enriquecimento de dados no HubSpot.
O que esta API não faz por si
Não há base de dados consultável. Peça à Enrow «todos os CTO de Berlim em empresas com mais de 200 pessoas» e não obtém nada, porque não há nenhuma lista para consultar. A pesquisa de email precisa de um nome completo e do domínio ou do nome da empresa. A de telefone precisa de um URL do LinkedIn.
É uma escolha deliberada, e tem um motivo. Os fornecedores de bases de dados atualizam-nas em ciclos de vários meses, pelo que uma parte considerável do que vendem descreve pessoas que já mudaram de emprego. A Enrow faz a pesquisa no momento do pedido, e é por isso que a precisão se mantém. Em contrapartida, a construção da lista fica do seu lado. Faça a lista no LinkedIn ou no Sales Navigator e depois entregue-a à API. As sequências de envio ficam para a Emelia, a La Growth Machine ou o lemlist.
Quanto custa cada contacto válido
Como só se cobram os resultados encontrados, o preço de tabela e o custo real coincidem. O Start custa 15 €/mês por 1 000 créditos, ou seja, 0,015 € por email válido. O Pro, 75 €/mês por 10 000: 0,0075 €. O Scale, 360 €/mês por 50 000, e a grelha mensal sobe até aos 200 000 créditos por 1 250 €/mês. Com esse escalão de topo em pagamento anual, o email fica a 0,0056 €, a tarifa mais baixa da tabela. Um telemóvel direto custa 40 créditos, 0,30 € no Pro. A verificação, 0,25 crédito por controlo, esteja o endereço vivo ou morto.
Compare isto com um fornecedor que cobra por tentativa, para o mesmo volume mensal e na mesma base de cobrança, e não preço de tabela contra preço de tabela. Uma ferramenta a 0,02 € por pesquisa tentada, com uma taxa de cobertura de 30%, sai-lhe a 0,067 € por contacto encontrado, e isto antes de contar os que fazem bounce. É esse o único número que vale a pena pôr numa folha de cálculo.
Não há custo por utilizador, o Pro aceita até 10 pessoas na equipa, o Scale não tem limite, e os créditos transitam de mês para mês até 3× o plano no Pro e 6× no Scale. O plano gratuito dá 50 créditos, renovados todos os meses, sem cartão.
pronto para passar à velocidade superior?
Ligado em minutos.
Data verificada em segundos.
FAQ
Uma pesquisa sem resultado gasta um crédito?
Depende do fornecedor, e é a primeira coisa a verificar. A Enrow, o Anymail Finder e o Findymail dizem todos que os endpoints de pesquisa só cobram os resultados encontrados; o ZeroBounce não cobra nada quando o resultado é «unknown». As ferramentas que cobram por tentativa cobram o próprio pedido. Com uma taxa de cobertura de 30% numa lista B2B fria, o custo real por contacto mais do que triplica, o que pesa muito mais do que qualquer diferença no preço anunciado.
Existe alguma API de email finder gratuita?
Há planos gratuitos; APIs gratuitas para sempre e com volume, em regra, não há, porque cada pesquisa obriga o fornecedor a um trabalho SMTP real. A Enrow dá 50 créditos, renovados todos os meses, sem cartão: 50 emails verificados ou 200 verificações, por tempo indeterminado, na aplicação, na extensão Chrome e nos assistentes de IA. A API abre com qualquer compra: um plano a partir de 15 €/mês ou um pacote de créditos sem subscrição.
Com que rapidez deve responder uma API de email finder?
Uma pesquisa síncrona que demore mais do que uns cinco segundos cria problemas em qualquer interface com um utilizador do outro lado. O Hunter deixa afinar isso com o parâmetro max_duration, entre 3 e 20 segundos, e diz que mais tempo significa mais exatidão. Em trabalho de lote, o que conta é a capacidade de processamento, e a latência por linha é irrelevante. Ninguém publica um p95, portanto meça-o por sua conta.
Dá para usar uma API de email finder em massa?
Dá, e acima de umas centenas de linhas convém. A Enrow aceita até 5 000 contactos por lote de pesquisa de email e 3 000 por lote de telefone, com os resultados a chegar por webhook ou por GET. A API v2 do Hunter não tem endpoint de pesquisa em massa, pelo que aí o processamento em massa se faz no painel de controlo. Confirme que o endpoint existe antes de desenhar a arquitetura à volta dele.
É seguro repetir uma pesquisa que esgotou o tempo limite?
Tecnicamente, sim, mas faça as contas primeiro. O POST não é idempotente segundo o RFC 9110, e o Idempotency-Key é um rascunho do IETF caducado, com suporte desigual entre fornecedores, logo uma repetição costuma ser um segundo evento a pagar. Com cobrança por resultado válido, uma repetição que não encontra nada não custa nada, o que torna viáveis tempos limite agressivos. Ainda assim, guarde o registo dos identificadores de pesquisa em curso.
Posso enriquecer legalmente contactos que não fui eu a recolher?
Na União Europeia, a base jurídica é o interesse legítimo, previsto no artigo 6.º, n.º 1, alínea f) do RGPD, acompanhado do dever de informar a pessoa de que se dispõe dos seus dados (artigo 14.º) e da dispensa prevista no artigo 14.º, n.º 5, alínea b), quando essa informação exigir um esforço desproporcionado. A prospeção B2B costuma enquadrar-se aqui, mas a avaliação compete a quem enriquece os dados e tem de ficar documentada — com um advogado, não com um artigo de blogue.
Aplique os quatro critérios à sua própria lista. A API da Enrow abre com qualquer compra (um plano a partir de 15 €/mês ou um pacote de créditos sem subscrição) e dá-lhe uma chave em cerca de trinta segundos. Os 50 créditos mensais do plano gratuito, sem cartão, funcionam na aplicação, na extensão Chrome e nos assistentes de IA.