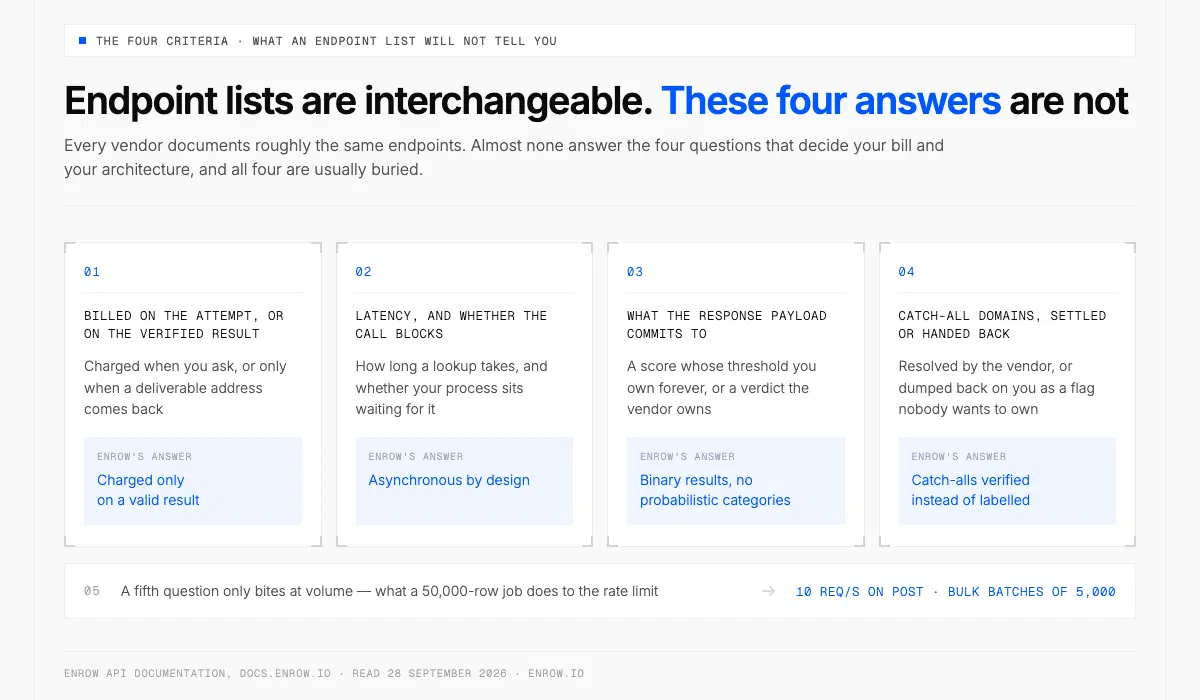
Tous les éditeurs documentent les mêmes endpoints ; les quatre réponses qui décident de votre facture, presque aucun ne les donne.
À retenir Une API email finder part d'une personne que vous avez déjà identifiée — un nom, une entreprise — et renvoie une adresse professionnelle vérifiée. Tous les éditeurs documentent à peu près les mêmes endpoints. Presque aucun ne répond aux quatre questions qui déterminent votre facture et votre architecture : la facturation (à la demande ou au résultat vérifié), la durée d'une recherche et le caractère bloquant ou non de l'appel, ce sur quoi le payload de réponse s'engage vraiment, et le sort d'un domaine catch-all, tranché ou laissé à votre charge. Une cinquième ne se pose qu'en volume : ce que deviennent les limites de débit face à un traitement de 50 000 lignes. Les réponses d'Enrow, à titre de repère : facturation au résultat valide uniquement, des endpoints asynchrones par conception, des catch-all vérifiés plutôt qu'étiquetés, 10 requêtes par seconde sur les POST, des lots de 5 000 lignes. Lisez la ligne « facturation » avant la liste des fonctionnalités. Elle pèse plus lourd sur le coût réel que le prix affiché.
Une API email finder, c'est un endpoint HTTP qui retrouve l'adresse email professionnelle d'une personne. Vous envoyez un nom et une entreprise. Vous récupérez une adresse, avec une indication sur son existence réelle.
Première mise au point, parce que la requête « email API » ramène surtout autre chose : des plateformes d'envoi et des relais transactionnels. Ces services-là envoient des emails. Une API de recherche, elle, trouve l'adresse d'une personne avant même qu'un message existe.
Les quatre critères qui suivent viennent de la construction de notre propre API, et de la douzaine de docs concurrentes lues pendant ce chantier. Les listes d'endpoints sont interchangeables. Le modèle de facturation, l'engagement de latence, la forme de la réponse et le traitement des catch-all ne le sont pas, et ces quatre points sont en général bien cachés. Le plafond des lots compte aussi, mais seulement quand votre volume devient sérieux : il a droit à sa propre section, juste après.
1. Facturation à la tentative ou au résultat vérifié
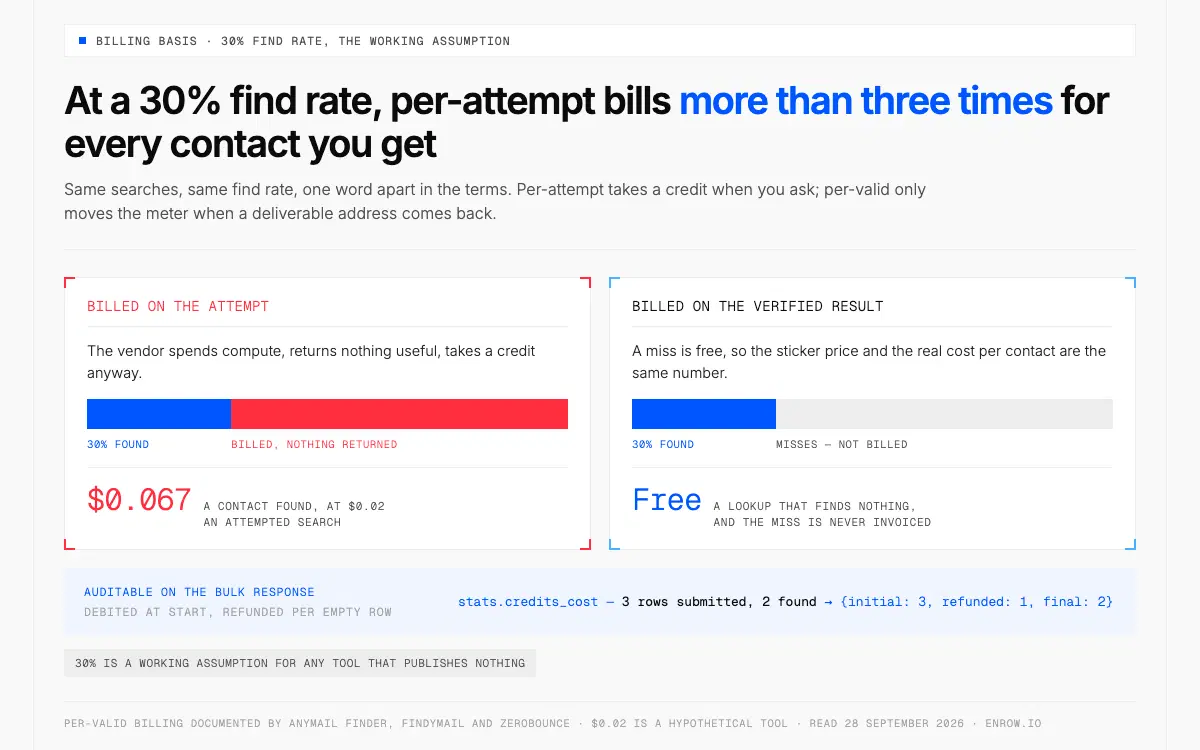
Payez les échecs, et chaque contact trouvé vous revient à plus de trois fois le prix de la recherche.
C'est là que tout se joue, et c'est justement la ligne que la plupart des pages de tarifs oublient.
Deux modèles existent. En facturation à la tentative, vous payez au moment où vous demandez : l'éditeur fait tourner ses serveurs, ne renvoie rien d'exploitable et débite quand même un crédit. En facturation au résultat valide, un échec ne coûte rien, et le compteur ne bouge que lorsqu'une adresse vérifiée revient.
L'écart est loin d'être négligeable. La plupart des éditeurs ne publient aucun taux de couverture, donc je retiens 30 % comme hypothèse de travail sur une liste B2B froide. À 30 %, un éditeur qui facture à la tentative vous fait payer chaque contact réellement obtenu plus de trois fois son prix. Ensuite, une partie des adresses trouvées génère des bounces, et celles-là aussi, vous les avez payées.
Quelques éditeurs mettent la facturation au résultat noir sur blanc, et c'est appréciable. Anymail Finder ne prend un crédit qu'une fois l'adresse vérifiée. Même principe chez Findymail : un crédit par adresse trouvée. ZeroBounce facture les recherches abouties, et rien quand le résultat est inconnu.
Les endpoints de recherche d'Enrow fonctionnent de la même façon, et la réponse en lot rend la comptabilité vérifiable. Un GET en lot renvoie stats.credits_cost sous forme de trois nombres : initial, refunded, final. Les crédits sont débités au lancement du lot, puis recrédités pour chaque ligne vide. L'exemple de la doc soumet 3 lignes, en trouve 2, et se solde à {initial: 3, refunded: 1, final: 2}. Vous pouvez rapprocher un mois de dépenses des lignes réellement trouvées, sans ouvrir le moindre ticket au support.
Une réserve, parce qu'elle joue dans l'autre sens. L'Email Verifier d'Enrow se facture au contrôle, 0,25 crédit, pas au résultat valide. Envoyez-lui des adresses mortes et vous payez quand même 0,25 par ligne. Trouver se paie au résultat ; vérifier se paie au contrôle. À garder en tête avant de faire passer un nettoyage de base par le mauvais endpoint.
2. Latence : appel bloquant ou non
Deux partis pris de conception s'affrontent, et aucun n'est mauvais.
Certaines API répondent en synchrone. Anymail Finder annonce que la plupart des recherches unitaires reviennent en trois secondes environ. Hunter va jusqu'à exposer l'arbitrage sous forme de paramètre : max_duration, entre 3 et 20 secondes, 10 par défaut, la doc précisant qu'une durée plus longue lui permet d'affiner les résultats et de renvoyer des données plus exactes. Un réglage d'une honnêteté rare. La précision se paie en millisecondes, et Hunter vous laisse choisir combien en dépenser.
Enrow a fait le choix inverse. Tous les endpoints sont asynchrones. Un POST sur /email/find/single renvoie immédiatement un identifiant de recherche, et le résultat arrive par webhook ou en interrogeant le GET correspondant. La doc précise que c'est voulu : un gros volume ne doit jamais bloquer l'appelant. Pendant que la recherche tourne, le GET répond {"qualification": "ongoing"}.
La vérification elle-même prend quelques secondes. Mais votre traitement ne reste pas bloqué à l'attendre, et un code qui cherche l'adresse dans la réponse du POST ne l'y trouvera pas.
Le bon choix dépend de l'endroit où la recherche intervient. Dans un formulaire, sous les yeux d'un utilisateur, un appel synchrone de trois secondes ne pose aucun problème. Dans un traitement de nuit sur 40 000 lignes, un appel bloquant devient un risque. La RFC 9110 §15.3.3 couvre ce second cas : 202 Accepted signifie que la requête est acceptée pour un traitement encore en cours.
Ce que personne ne publie, c'est un p95. Ni Enrow, ni les éditeurs cités plus haut. Le marketing dit « en quelques secondes » et aucun ne s'engage sur un percentile. Mesurez-le sur votre propre volume avant de bâtir une architecture autour d'un chiffre de landing page.
3. Ce que le payload de réponse vous dit vraiment
Ici, le marché se partage entre deux écoles, et se tromper d'école vous coûte des semaines de développement.
Première école : on vous confie l'incertitude. L'Email Finder de Hunter renvoie un score de 0 à 100, un booléen accept_all, un objet verification dont le statut vaut valid, accept_all ou unknown, et jusqu'à vingt entrées sources qui indiquent la page où la mention a été trouvée, avec les dates extracted_on et last_seen_on. Sa doc dit clairement ce que mesure le score sur un domaine accept-all : la probabilité que l'adresse soit valide. ZeroBounce fait la même chose sur une échelle plus sommaire, avec un email_confidence à HIGH, MEDIUM ou LOW et l'une des neuf valeurs de failure_reason.
C'est utile si vous construisez votre propre couche de scoring. Le tableau sources est un vrai outil d'enquête.
Seconde école : on tranche la question et on vous rend un verdict. Le finder d'Enrow renvoie une qualification à valid ou invalid, avec ongoing tant que la recherche tourne. La doc l'écrit sans détour : des résultats binaires, aucune catégorie probabiliste. S'y ajoutent email, un bloc info qui contient le domaine et le nom de l'entreprise, le prénom et le nom, et l'objet custom que vous aviez envoyé.
La bonne question n'est pas de savoir quel payload est le plus riche. C'est de savoir qui fixe le seuil. Si l'API vous renvoie un score 0-100 et un accept_all: true, ce seuil vous revient pour de bon, et chaque commercial qui se plaint d'un bounce se plaint en réalité d'un chiffre que vous avez choisi. Si elle renvoie valid ou invalid, le seuil appartient à l'éditeur, et c'est à lui que vous demandez des comptes.
L'objet custom vous épargne toute une catégorie de code de plomberie. Ce que vous y mettez — par requête, et ligne par ligne dans un lot — revient intact dans la réponse du GET et dans le webhook. Identifiant de contact interne, tag de campagne, identifiant de fiche CRM : bref, ce qui sert de clé à votre traitement. Pas de table de rapprochement à maintenir.
4. Domaines catch-all : tranchés, ou laissés à votre charge
Un domaine accept-all répond oui à toutes les adresses que vous testez. Boîte réelle, faute de frappe, suite de caractères absurde : tout est accepté. Ce n'est pas une défaillance de l'éditeur, c'est prévu par le protocole. La RFC 5321 §3.5.3 l'anticipe : il existe des cas où une adresse paraît valide sans pouvoir être raisonnablement vérifiée en temps réel, et le serveur doit alors renvoyer un 252. Et le §3.3 note que certains serveurs ne contrôlent le destinataire qu'à l'arrivée du corps du message : une adresse acceptée peut donc bouncer plus tard.
Un seul test SMTP ne peut pas trancher. C'est une limite du protocole, pas des outils.
La plupart des API vous transmettent donc l'ambiguïté. Le vérificateur de Hunter renvoie accept_all, et sa propre doc prévient que lorsque le serveur SMTP accepte tout, les contrôles SMTP peuvent produire des faux positifs. C'est honnête, et ça vous laisse sur les bras un paquet de lignes dont personne ne veut.
Ne jetez pas ce paquet. Les listes B2B surreprésentent justement les entreprises les plus susceptibles d'être en accept-all : supprimer sur la seule foi de cet indicateur, c'est jeter des décideurs bien vivants avec les lignes mortes.
Enrow tranche les catch-all de façon déterministe au lieu de les étiqueter : plusieurs passes SMTP depuis des serveurs situés dans des régions différentes, confrontées à des adresses de contrôle volontairement fausses sur le même domaine, le tout dans le cadre des plus de 10 vérifications qui précèdent chaque résultat. Un catch-all tranché revient valid et se facture comme trouvé. Celui qu'on n'arrive pas à trancher revient invalide et ne coûte rien. Cette vérification est comprise dans le prix du crédit, ce n'est pas une option payante. Le taux de bounce observé reste sous 1 % : c'est une moyenne relevée sur de vrais envois, pas une garantie. Le mécanisme est détaillé dans qu'est-ce qu'un email catch-all, les dégâts en aval dans le taux de bounce.
Bulk email finder : endpoints en lot et limites de débit
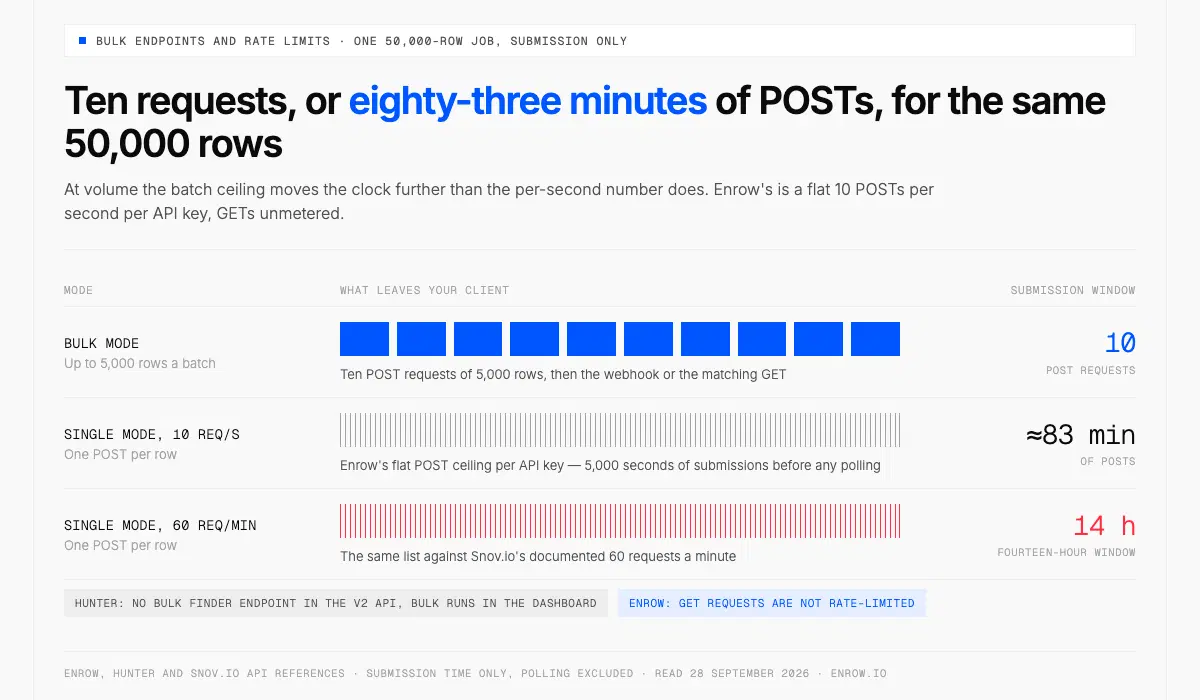
En volume, la taille du lot prime sur le plafond par seconde : dix requêtes contre environ 83 minutes de POST.
Un bulk email finder, c'est un endpoint qui accepte une liste entière de contacts en une seule requête et renvoie les adresses vérifiées sous forme de traitement par lot, au lieu d'un appel HTTP par personne. C'est la différence entre une chaîne qui se termine dans la nuit et une chaîne qui ne se termine pas.
Les plafonds de lot et les limites de débit varient énormément d'un éditeur à l'autre, et leurs effets se cumulent.
| Éditeur | Recherche en lot | Limite de débit publiée |
|---|---|---|
| Enrow | Jusqu'à 5 000 lignes par lot (3 000 pour les téléphones) | 10 req/s sur tous les endpoints POST ; les GET ne sont pas limités |
| Hunter | Aucun endpoint de recherche en lot dans l'API v2 ; le traitement en lot passe par l'interface | Email Finder 15 req/s et 500 req/min ; vérificateur 10 req/s et 300 req/min |
| Anymail Finder | Jusqu'à 100 000 lignes par traitement, résultats par webhook (annonce de l'éditeur) | Aucune limite journalière ni horaire (annonce de l'éditeur, aucun SLA publié) |
| Snov.io | La recherche en lot existe dans le produit ; aucun endpoint de lot décrit dans la référence API | 60 requêtes par minute |
Faites le calcul sur un traitement de 50 000 lignes. En recherches unitaires, avec un plafond de 10 req/s, ça donne 5 000 secondes de soumission, soit environ 83 minutes de POST avant même de commencer à récupérer les résultats. Le même traitement en mode lot, c'est dix requêtes. Avec les 60 requêtes par minute documentées chez Snov, le mode unitaire s'étale sur quatorze heures.
En volume, la taille du lot pèse donc plus lourd que le nombre de requêtes par seconde. Le plafond d'Enrow est fixe : 10 POST par seconde et par clé API, les GET ne sont pas comptés, et une augmentation s'obtient sur demande à api@enrow.io. Aucun plafond supérieur n'est publié : ne bâtissez donc rien sur un chiffre qui n'existe pas.
Réessais, idempotence, et pourquoi la facturation change votre stratégie
POST n'est pas idempotent. La RFC 9110 §9.2.2 dit qu'un client peut rejouer une requête quand aucune réponse n'arrive, mais à condition que cette requête puisse être considérée comme idempotente pour les besoins du réessai — ce qu'un POST de recherche n'est pas. Une requête rejouée après un timeout devient un second événement facturable, sauf si l'éditeur la déduplique.
L'en-tête vers lequel tout le monde se tourne, Idempotency-Key, n'est pas un standard. C'est un Internet-Draft de l'IETF, draft-ietf-httpapi-idempotency-key-header, expiré à la révision 07. Sa prise en charge dépend de chaque éditeur et reste inégale. Hunter l'implémente proprement — TTL de 24 heures, empreinte du corps de la requête, quatre codes d'erreur distincts — mais seulement sur ses endpoints sequences et messages. Pas sur l'Email Finder.
En facturation à la tentative, c'est un vrai problème. Votre logique de réessai devient une décision budgétaire, et un backoff agressif sur un réseau instable double la facture du mois sans prévenir.
En facturation au résultat, le problème disparaît en grande partie. Une recherche rejouée qui ne trouve rien ne coûte rien : vous pouvez régler des timeouts agressifs sans surveiller le compteur. En grande partie, pas totalement — un réessai qui retrouve la même adresse reste un résultat trouvé, et Enrow ne publie aucune garantie de déduplication. Gardez votre propre journal des identifiants de recherche en cours. Le paiement au résultat rend les réessais bon marché, pas gratuits.
Deux autres choses qu'Enrow ne fournit pas, et autant le dire franchement, sinon vous les découvrirez à deux heures du matin. Il n'y a pas d'en-têtes X-RateLimit-*, et un 429 revient sous la forme d'un simple {"message": "Too Many Requests"}. La RFC 6585 §4 rend Retry-After facultatif, Enrow l'omet, et la doc vous demande donc de construire vous-même un backoff exponentiel calé sur le plafond fixe. Quant au 404, il ne figure pas du tout dans les codes de statut documentés — la liste se limite à 400, 401, 402, 429 et 500 — donc un gestionnaire qui attend un 404 net pour un identifiant de recherche inconnu ou expiré ne se déclenchera jamais.
L'intégration en pratique
L'authentification passe par une clé API dans un en-tête x-api-key. Pas de flux OAuth, pas de bearer token, et la doc l'écrit en toutes lettres. L'URL de base est https://api.enrow.io.
Chaque POST a son GET : /email/find/single, /email/find/bulk, /email/verify/single, /email/verify/bulk, /phone/single, /phone/bulk, plus un GET /account/info qui renvoie votre solde de crédits sous forme d'un nombre unique, ainsi que les URL de webhook configurées.
Six événements de webhook couvrent ces endpoints. Les événements de recherche unitaire contiennent le résultat complet : une intégration unitaire bien faite n'a donc jamais besoin d'interroger l'API. Les événements de lot signalent seulement que le traitement est terminé ; les lignes et le décompte des crédits viennent du GET correspondant. L'URL de webhook se règle globalement sur la page des intégrations, ou requête par requête dans settings.webhook ; HTTPS obligatoire, et elle doit répondre 200.
Les erreurs qui méritent un traitement : 401 pour une clé invalide, 402 pour un solde de crédits insuffisant, 429 pour la limite de débit. Attention au 402 — il répond {reason, success} sur les endpoints unitaires et un simple {message} sur les lots, de quoi casser un parseur d'erreurs commun aux deux. Des SDK officiels existent désormais, dans sept langages : JS/TypeScript, Python, PHP, Go, Java, Swift et Rust, d'après docs.enrow.io/sdks/overview au 29 août 2026. Les sept sont en early access et s'installent depuis les sources GitHub plutôt que depuis un registre de paquets — vous épinglez donc un commit vous-même, et les exemples curl et JavaScript de la doc restent le filet de secours. La spécification complète est sur la page API d'Enrow ; obtenir une clé prend une trentaine de secondes, sans passer par un commercial.
Si votre appelant est un agent IA plutôt qu'un service, il existe un serveur MCP officiel : le dépôt EnrowAPI/enrow-mcp sur GitHub, sous licence MIT, installé par npm ou lancé via npx. Il expose la recherche d'email, la vérification et la recherche de numéro sous forme d'outils — find_email, find_emails_bulk, verify_email, find_phone et leurs équivalents de récupération de résultat — et la doc cite Claude Desktop, Cursor et Windsurf comme clients. Un assistant trouve les coordonnées d'un contact en pleine conversation, sans une ligne de code d'intégration.
L'extension Chrome email finder : la voie sans code
Beaucoup de gens qui ont besoin de cette donnée n'ouvriront jamais un terminal. Pour eux, le bon outil, c'est une extension Chrome, pas une API.
L'extension d'Enrow part d'un profil LinkedIn ou Sales Navigator. En un clic, la fiche complète arrive dans HubSpot, Salesforce ou Pipedrive : nom, email vérifié, numéro de portable, entreprise, URL LinkedIn. Pas une adresse copiée puis collée dans un champ — toute la fiche contact. La facturation est celle de l'API : un crédit par email vérifié, 40 par numéro vérifié, rien sans résultat.
Les RevOps construisent la chaîne, les commerciaux traitent des profils. Même compteur de crédits, même vérification, deux points d'entrée. Pour aller plus loin : le guide email finder LinkedIn et l'article sur l'enrichissement HubSpot.
Ce que cette API ne fera pas pour vous
Pas de base interrogeable. Demandez à Enrow « tous les CTO de Berlin dans des entreprises de plus de 200 personnes » et vous n'obtiendrez rien, parce qu'il n'y a aucune liste à interroger. La recherche d'email a besoin d'un nom complet et d'un domaine ou d'un nom d'entreprise ; celle de numéro, d'une URL LinkedIn.
C'est un arbitrage assumé, et voici pourquoi. Les éditeurs de bases de données mettent leurs fiches à jour sur des cycles qui se comptent en mois : une part non négligeable de ce qu'ils vendent décrit des gens qui ont déjà changé de poste. Enrow cherche au moment de la demande, et c'est ce qui garantit la précision. Le prix à payer, c'est que le sourcing devient votre affaire. Constituez la liste sur LinkedIn ou Sales Navigator, puis passez-la à l'API. Pour les campagnes, allez chez Emelia, La Growth Machine ou lemlist.
Ce que coûte un contact vérifié
Comme la facturation porte sur le résultat trouvé, le prix affiché et le coût réel se confondent. Start, c'est 15 €/mois pour 1 000 crédits, soit 0,015 € l'email valide. Pro, 75 €/mois pour 10 000, soit 0,0075 €. Scale, 360 €/mois pour 50 000, et la grille mensuelle monte jusqu'à 200 000 crédits à 1 250 €/mois. Passez ce dernier palier en annuel et l'email revient à environ 0,0056 €, le meilleur tarif de la grille. Un numéro de portable coûte 40 crédits, environ 0,30 € sur Pro. La vérification, 0,25 crédit par contrôle, que l'adresse soit vivante ou morte.
Comparez avec un éditeur qui facture à la tentative, à volume mensuel égal et sur la même base de facturation, pas en opposant deux prix affichés. Prenez un outil à 0,02 € la recherche tentée, avec un taux de couverture de 30 % : il vous coûte 0,067 € le contact trouvé, avant même de compter les bounces. C'est le seul chiffre qui mérite d'entrer dans un tableur.
Pas de facturation par utilisateur, jusqu'à 10 membres d'équipe sur Pro et sans limite sur Scale, et des crédits qui se reportent jusqu'à 3 fois votre forfait sur Pro et 6 fois sur Scale. L'offre gratuite, elle, donne 50 crédits chaque mois, de façon récurrente, sans carte bancaire.
utilisateur illimité
Prêt à passer à la vitesse supérieure
FAQ
Une recherche infructueuse consomme-t-elle un crédit ?
Ça dépend de l'éditeur, et c'est la première chose à vérifier. Enrow, Anymail Finder et Findymail écrivent tous les trois que leurs endpoints de recherche ne facturent qu'un résultat trouvé ; ZeroBounce ne facture rien quand le résultat est inconnu. Les outils qui facturent à la tentative, eux, font payer la demande. Partez d'un taux de couverture de 30 % sur une liste B2B froide : la facturation à la tentative multiplie par plus de trois le coût réel par contact, de quoi effacer n'importe quelle différence de prix affiché.
Existe-t-il une API email finder gratuite ?
Des offres gratuites, oui. Des API gratuites en permanence et en volume, en général non, parce que chaque recherche demande au fournisseur un vrai travail SMTP. Enrow donne 50 crédits chaque mois, de façon récurrente et sans carte : 50 emails vérifiés, ou 200 contrôles de vérification, indéfiniment, dans l'application, l'extension Chrome et les assistants IA. L'API, elle, s'ouvre dès le premier achat : un forfait à partir de 15 €/mois ou un pack de crédits sans abonnement.
En combien de temps une API email finder doit-elle répondre ?
Un appel synchrone qui dépasse cinq secondes environ pose des problèmes dès qu'un utilisateur attend devant son écran. Hunter vous laisse régler ce curseur avec un paramètre max_duration compris entre 3 et 20 secondes, et précise dans sa doc qu'une durée plus longue donne des données plus exactes. Sur du traitement par lot, c'est le débit qui compte, pas la latence ligne par ligne. Aucun acteur du marché ne publie de p95 : mesurez-le sur votre propre volume.
Peut-on utiliser une API email finder en lot ?
Oui, et c'est même conseillé au-delà de quelques centaines de lignes. Enrow accepte jusqu'à 5 000 contacts par lot de recherche d'emails et 3 000 par lot de téléphones, et renvoie les résultats par webhook ou via un GET. L'API v2 de Hunter n'expose aucun endpoint de recherche en lot : le traitement par lot y passe par l'interface. Vérifiez que l'endpoint existe avant de bâtir votre architecture dessus.
Peut-on relancer sans risque une recherche après un timeout ?
Techniquement oui, mais calculez d'abord ce que ça coûte. POST n'est pas idempotent au sens de la RFC 9110, et Idempotency-Key est un draft IETF expiré dont le support varie d'un éditeur à l'autre : un réessai est donc en principe un second événement facturable. En facturation au résultat valide, un réessai qui ne trouve rien ne coûte rien, ce qui rend les timeouts agressifs abordables. Gardez quand même la trace des identifiants de recherche en cours.
Ai-je le droit d'enrichir des contacts que je n'ai pas collectés moi-même ?
Dans l'UE, la question relève de l'article 6(1)(f) du RGPD (l'intérêt légitime), avec l'obligation d'information de l'article 14 et l'exemption de l'article 14(5)(b) quand cette information demande des efforts disproportionnés. La prospection B2B entre souvent dans ce cadre, mais c'est à vous de mener et de documenter l'analyse — avec un avocat, pas avec un article de blog.
Testez les quatre critères sur votre propre liste. L'API d'Enrow s'ouvre dès le premier achat (un forfait à partir de 15 €/mois ou un pack de crédits sans abonnement) et vous remet une clé en une trentaine de secondes. Les 50 crédits mensuels de l'offre gratuite, sans carte, servent dans l'application, l'extension Chrome et les assistants IA.