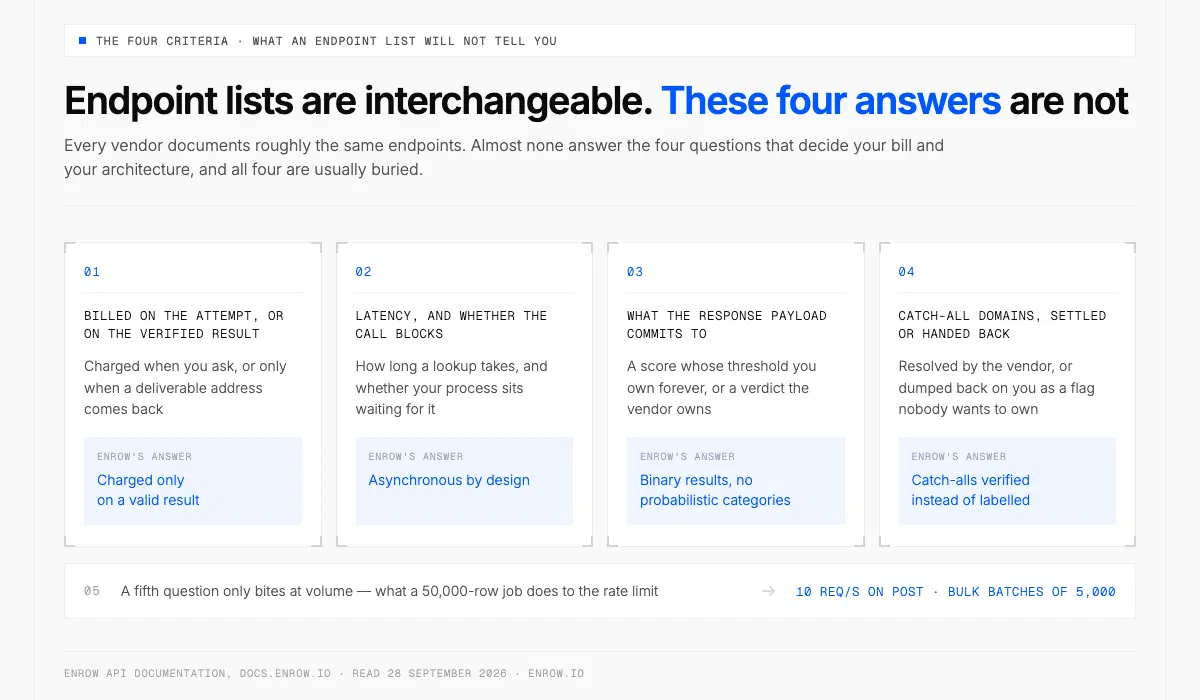
Todos los proveedores documentan los mismos endpoints; las cuatro respuestas que deciden tu factura, casi nadie las publica.
Lo esencial Una API de email finder parte de una persona que ya tienes identificada (normalmente, un nombre y una empresa) y te devuelve su dirección profesional verificada. Los endpoints que documenta cada proveedor son prácticamente los mismos. Lo que casi nadie contesta son las cuatro preguntas que deciden tu factura y tu arquitectura: si se cobra el intento o el resultado verificado, cuánto tarda una consulta y si te bloquea el proceso, qué garantiza realmente la respuesta, y si un dominio catch-all vuelve resuelto o te lo devuelven sin resolver. Hay una quinta que solo aprieta cuando hay volumen: cómo encaja un trabajo de 50.000 filas en el límite de peticiones. Las respuestas de Enrow, como referencia: solo se cobra el resultado válido, todo asíncrono a propósito, catch-all verificadas en vez de etiquetadas, 10 peticiones por segundo en los POST y lotes de 5.000 filas. Lee cómo factura antes de mirar la lista de funciones. Eso pesa mucho más en el coste real que el precio que ves.
Una API de email finder es un endpoint HTTP que encuentra la dirección de trabajo de una persona. Le mandas un nombre y una empresa. Te devuelve una dirección y alguna indicación de si existe de verdad.
Antes de nada, una aclaración, porque quien busca «email API» se topa sobre todo con otra cosa: proveedores de envío y servicios de email transaccional. Esos sirven para enviar. Un buscador hace el paso anterior: de una persona saca su dirección, antes de que exista ningún mensaje.
Los cuatro criterios que siguen salen de construir la API de Enrow y de leerme por el camino la documentación de una docena de competidores. Las listas de endpoints son intercambiables. El modelo de facturación, la latencia que prometen, el formato de la respuesta y el tratamiento de las catch-all no lo son, y los cuatro suelen estar bien escondidos. El tope por lote también cuenta, pero solo a partir de cierto volumen; por eso tiene sección propia, después de los cuatro.
1. ¿Pagas el intento o el resultado verificado?
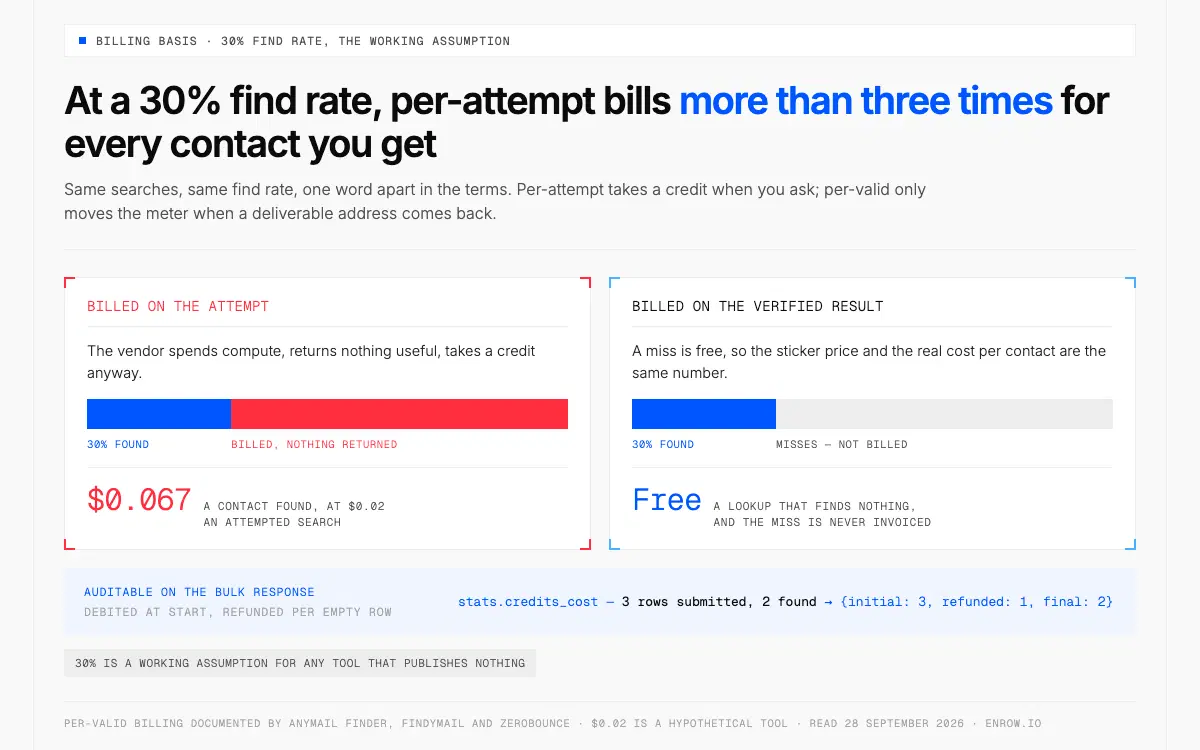
Si pagas los fallos, cada contacto encontrado te sale a más del triple de lo que cuesta la búsqueda.
Aquí se decide todo, y es justo el dato que la mayoría de las páginas de precios se salta.
Hay dos modelos. Con el primero se cobra cuando preguntas: el proveedor pone sus servidores a trabajar, no devuelve nada útil y se lleva el crédito igual. Con el segundo, un fallo sale gratis y solo se te descuenta un crédito cuando vuelve una dirección verificada.
La diferencia no es ninguna minucia. Las tasas de acierto sobre listas frías B2B se quedan bastante por debajo de la mitad, y para cualquier herramienta que no publica nada asumimos un 30 % de acierto. Con ese 30 %, quien cobra por intento te está facturando más de tres veces cada contacto que de verdad te llevas. Y luego una parte de lo que sí encontró hace bounce, y eso también lo has pagado.
Hay unos cuantos proveedores que lo ponen por escrito, y eso tiene su mérito. Anymail Finder solo descuenta un crédito cuando la dirección está verificada. Findymail, igual: un crédito por dirección encontrada. ZeroBounce factura la búsqueda que sale bien y no cobra nada por la que da un resultado desconocido.
Los endpoints de búsqueda de Enrow funcionan igual, y la respuesta de un lote deja las cuentas a la vista. El GET de un lote devuelve stats.credits_cost con tres números, initial, refunded y final. Los créditos se descuentan cuando arranca el lote y se devuelven por cada fila que vuelve vacía. El ejemplo de la documentación manda 3 filas, encuentra 2 y cierra en {initial: 3, refunded: 1, final: 2}. Puedes cuadrar el gasto de un mes con las filas encontradas sin abrir un ticket a soporte.
Una salvedad, porque esta va en tu contra. El Email Verifier de Enrow se cobra por comprobación, 0,25 créditos, y no por resultado válido. Si le metes direcciones muertas, pagas 0,25 por fila igual. Buscar se factura sobre lo que se encuentra; verificar se factura sobre lo que se comprueba. Tenlo claro antes de lanzar una limpieza de base por el endpoint que no toca.
2. Latencia: ¿te bloquea la llamada?
Hay dos filosofías de diseño, y ninguna de las dos está mal.
Algunas API contestan de forma síncrona. Anymail Finder dice que la mayoría de sus consultas sueltas vuelven en unos tres segundos. Hunter te deja elegir entre rapidez y precisión con un parámetro, max_duration, de 3 a 20 segundos (10 por defecto), y su documentación explica que una duración más larga les permite afinar el resultado y devolver datos más precisos. Un ajuste poco habitual, y honesto. La precisión cuesta milisegundos y te dejan gastarlos.
Enrow optó por la otra vía. Todos los endpoints son asíncronos. Un POST a /email/find/single te devuelve un id de búsqueda al momento, y el resultado llega por webhook o consultando el GET correspondiente. La documentación dice que eso es a propósito, para que un volumen grande no bloquee nunca a la aplicación que hace la llamada. Mientras la búsqueda está en curso, el GET responde {"qualification": "ongoing"}.
La verificación en sí se resuelve en segundos. Solo que tu proceso no se queda esperándola, y el código que cuente con tener la dirección en la respuesta del POST no la va a encontrar ahí.
Cuál te conviene depende de dónde se lanza la consulta. En un formulario que alguien tiene delante, una llamada síncrona de tres segundos no da ningún problema. En un proceso nocturno sobre 40.000 filas, una llamada que bloquea es un riesgo. El segundo caso lo cubre el RFC 9110 §15.3.3: un 202 Accepted significa aceptado para un procesamiento que todavía no ha terminado.
Lo que no publica nadie es un p95. Ni Enrow ni ninguno de los de arriba. El marketing dice «en segundos» y nadie se moja con un percentil. Mídelo con tu propio volumen antes de montar una arquitectura sobre la cifra de una landing.
3. Qué te dice de verdad la respuesta
Aquí el mercado se divide en dos escuelas, y elegir la que no te conviene cuesta semanas de ingeniería.
La primera te pasa la incertidumbre a ti. El Email Finder de Hunter devuelve un score de 0 a 100, un booleano accept_all, un objeto verification con estado valid, accept_all o unknown, y hasta veinte entradas en sources con la página de la que salió cada mención y sus fechas extracted_on y last_seen_on. Su documentación es franca sobre lo que vale ese score en un dominio que lo acepta todo: estima la probabilidad de que la dirección sea válida. ZeroBounce hace lo mismo con menos detalle: devuelve email_confidence como HIGH, MEDIUM o LOW, más uno de los nueve valores de failure_reason.
Sirve si te estás montando tu propia capa de puntuación. El array sources es una herramienta forense seria.
La segunda zanja la pregunta y te da un veredicto. El buscador de Enrow devuelve qualification como valid o invalid, y ongoing mientras la búsqueda corre. La documentación lo dice sin rodeos: resultados binarios, sin categorías probabilísticas. Junto a ese campo vienen email, un bloque info con el dominio y el nombre de la empresa, el nombre y el apellido, y el objeto custom que tú mandaste.
La pregunta no es cuál de las dos respuestas trae más datos. Lo que cuenta es quién decide el umbral. Si la API te devuelve un 0-100 y un accept_all: true, el umbral es tuyo para siempre, y cada comercial que se queje de un bounce se está quejando de un número que has elegido tú. Si te devuelve válido o inválido, el umbral es del proveedor y a él le pides cuentas.
El objeto custom te ahorra todo el código que solo sirve para asociar cada respuesta con su registro. Lo que metas ahí, por petición y por fila dentro de un lote, vuelve intacto en la respuesta del GET y en el webhook. El id interno del contacto, la etiqueta de campaña, el id del registro en el CRM, cualquier dato que tu proceso use como clave. Sin tabla de correspondencias.
4. Dominios catch-all: ¿te los resuelve o te pasa la pelota?
Un dominio que lo acepta todo dice que sí a cualquier dirección por la que preguntes. Buzón real, errata, disparate absoluto, todo aceptado. No es un fallo del proveedor, está en el protocolo. El RFC 5321 §3.5.3 lo prevé: hay circunstancias en las que una dirección parece válida y no se puede verificar razonablemente en tiempo real, y entonces el servidor debería contestar un 252. El §3.3 añade que algunos servidores no comprueban el destinatario hasta que llega el cuerpo del mensaje, con lo cual una dirección aceptada todavía puede hacer bounce más tarde.
Con una sola prueba SMTP no hay manera de saberlo. Es un hecho del protocolo, no una carencia de la herramienta.
De modo que casi todas las API te pasan la ambigüedad. El verificador de Hunter devuelve accept_all, y su propia documentación avisa de que, cuando el servidor SMTP lo acepta todo, las comprobaciones SMTP pueden dar falsos positivos. Honesto, y te deja un montón de filas de las que nadie quiere hacerse responsable.
No tires ese montón. En las listas B2B abundan justo las empresas con más papeletas de tener un servidor que lo acepta todo, de manera que borrar todo lo que tiene esa etiqueta se lleva por delante a decisores reales junto con las filas muertas.
Enrow resuelve las catch-all de forma determinista en vez de marcarlas: pruebas SMTP repetidas desde servidores de regiones distintas, contrastadas con direcciones de control falsas a propósito en ese mismo dominio, dentro de las más de 10 verificaciones que hay detrás de cada resultado. Las catch-all resueltas vuelven como valid y se facturan como encontradas. Las que no se dejan resolver vuelven como inválidas y no cuestan nada. Verificar una catch-all va dentro del precio del crédito, no es un extra. El bounce observado se queda por debajo del 1 %, que es una media de envíos reales y nunca una promesa. La mecánica está en qué es un email catch-all, y el destrozo que provoca después, en la tasa de bounce.
Endpoints de búsqueda en masa y límites de peticiones
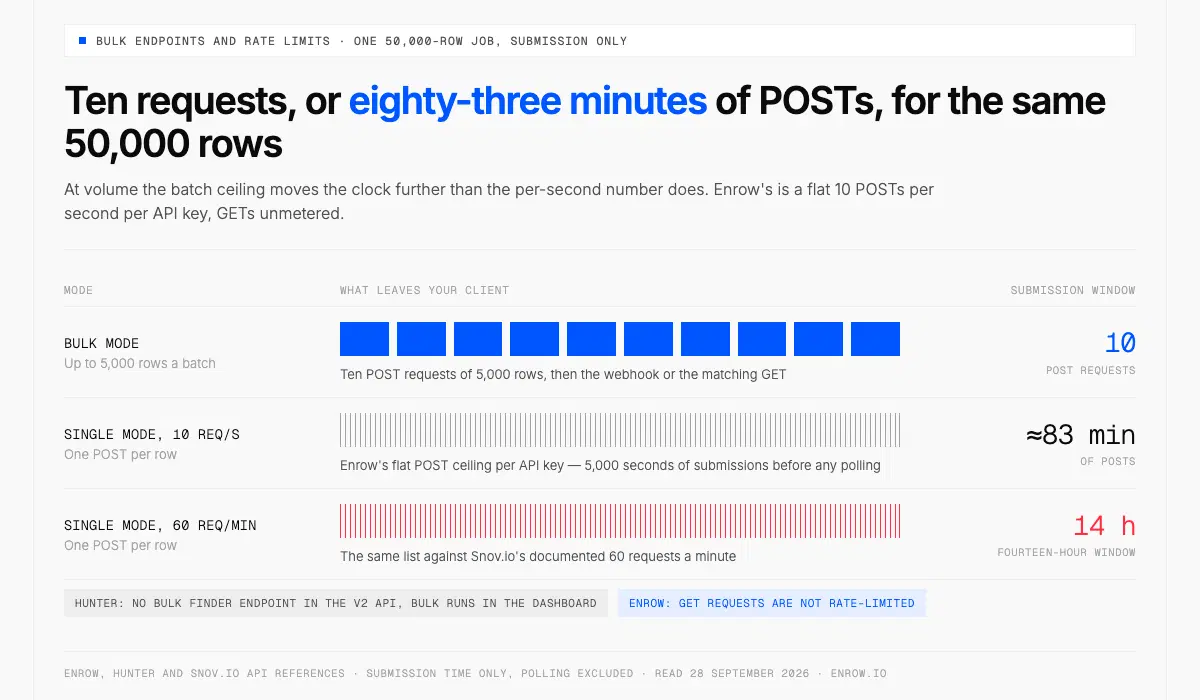
Con volumen, lo que cuenta es el tamaño del lote, no el tope por segundo: diez peticiones frente a unos 83 minutos de POST.
Un buscador de emails en masa es un endpoint que acepta una lista entera de contactos en una sola petición y devuelve las direcciones verificadas como un trabajo por lotes, en lugar de una llamada HTTP por persona. Es la diferencia entre un proceso que termina esta noche y uno que no termina nunca.
Los topes por lote y los límites de peticiones varían muchísimo, y además se condicionan entre sí.
| Proveedor | Búsqueda en masa | Límite de peticiones publicado |
|---|---|---|
| Enrow | Hasta 5.000 filas por lote (3.000 para teléfono) | 10 peticiones/s en todos los endpoints POST; los GET no tienen límite |
| Hunter | Ningún endpoint de búsqueda en masa en la API v2; los lotes se lanzan desde el panel | Email Finder 15 peticiones/s y 500/min; verificador 10 peticiones/s y 300/min |
| Anymail Finder | Hasta 100.000 filas por trabajo, resultados por webhook (dato del proveedor) | Sin límites diarios ni horarios (dato del proveedor, sin SLA publicado) |
| Snov.io | La búsqueda en masa es una función del producto; su referencia de API no describe ningún endpoint por lotes | 60 peticiones por minuto |
Haz la cuenta sobre un trabajo de 50.000 filas. En modo consulta suelta, con un tope de 10 peticiones por segundo, son 5.000 segundos de envíos, unos 83 minutos de POST antes siquiera de ponerte a recoger resultados. El mismo trabajo en modo lote son diez peticiones. Al ritmo de 60 por minuto que documenta Snov, el modo suelto se te va a catorce horas.
O sea que, con volumen, el tamaño del lote pesa más que la cifra por segundo. El tope de Enrow es fijo: 10 POST por segundo y por clave de API, los GET sin contar, y se puede pedir una subida escribiendo a api@enrow.io. Por encima de eso no hay ninguna cifra publicada, así que no montes nada dando una por buena.
Reintentos, idempotencia y por qué la facturación te cambia la estrategia
El POST no es idempotente. El RFC 9110 §9.2.2 dice que un cliente puede repetir una petición cuando no le llega respuesta, siempre que esa petición pueda considerarse idempotente, y un POST de búsqueda no lo es. Reintentar tras un tiempo de espera agotado supone un segundo cobro, salvo que el proveedor deduplique la petición.
La cabecera de la que echa mano todo el mundo, Idempotency-Key, no es un estándar. Es un borrador del IETF, draft-ietf-httpapi-idempotency-key-header, caducado en la revisión 07. Su soporte depende de cada proveedor y es irregular. Hunter la implementa como toca (TTL de 24 horas, huella del cuerpo de la petición, cuatro códigos de error distintos), pero solo en sus endpoints de secuencias y de mensajes. En el Email Finder, no.
Con facturación por intento, eso es un problema de los gordos. La lógica de reintento se convierte en una decisión de gasto, y un backoff agresivo sobre una red inestable te duplica la factura del mes sin hacer ruido.
Cuando solo se cobra el resultado válido, el problema casi desaparece. Un reintento que no encuentra nada no cuesta nada, con lo cual puedes apretar los tiempos de espera sin que eso te encarezca el mes. Casi, no del todo: un reintento que encuentra la misma dirección sigue siendo un resultado encontrado, y Enrow no publica ninguna garantía de deduplicación. Lleva tú el registro de los ids de búsqueda que tengas en curso. Cobrar solo lo válido abarata los reintentos, no los regala.
Dos cosas más que Enrow no te da, dichas a las claras porque, si no, te vas a enterar a las dos de la mañana. No hay cabeceras X-RateLimit-*, y un 429 vuelve pelado, {"message": "Too Many Requests"}. El RFC 6585 §4 deja Retry-After como opcional y Enrow no lo manda, de modo que su propia documentación te dice que te montes tú el backoff exponencial para ese tope fijo. Y el 404 no aparece en los códigos de estado documentados (la lista se queda en 400, 401, 402, 429 y 500), con lo cual un gestor de errores que espere un 404 limpio para un id de búsqueda desconocido o caducado no se va a disparar jamás.
Cómo se conecta
La autenticación es una clave de API en una cabecera x-api-key. Ni flujo OAuth ni tokens bearer, y la documentación lo dice con esas mismas palabras. La URL base es https://api.enrow.io.
Cada POST tiene su GET correspondiente: /email/find/single, /email/find/bulk, /email/verify/single, /email/verify/bulk, /phone/single y /phone/bulk, más un GET /account/info que te devuelve en una sola llamada el saldo de créditos que te queda y las URL de webhook que tengas configuradas.
Seis eventos de webhook cubren esos endpoints. Los de búsqueda suelta llevan el resultado entero, o sea que una integración unitaria bien montada nunca tiene que ir a buscar el resultado. Los de lote solo te dicen que el lote ha terminado; las filas y la cuenta de créditos salen del GET correspondiente. La URL del webhook se configura de forma global en la página de integraciones, o petición a petición en settings.webhook, solo por HTTPS, y tiene que contestar un 200.
Errores que merece la pena gestionar: un 401 por clave incorrecta, un 402 por créditos insuficientes y un 429 por el límite de peticiones. Ojo con el 402, porque contesta {reason, success} en los endpoints unitarios y solo {message} en los de lote, y eso rompe cualquier parser de errores compartido. Ya hay SDK oficiales en siete lenguajes: JS/TypeScript, Python, PHP, Go, Java, Swift y Rust, según docs.enrow.io/sdks/overview, consultado el 29 de agosto de 2026. Los siete están en acceso anticipado y se instalan desde el código de GitHub, no desde un registro de paquetes, así que el commit lo fijas tú y los ejemplos en curl y en JavaScript de la documentación siguen siendo el plan B. La especificación completa está en la página de la API de Enrow; obtener una clave lleva unos treinta segundos, sin llamada comercial.
Si quien llama es un agente de IA y no un servicio, hay un servidor MCP oficial, el repositorio EnrowAPI/enrow-mcp en GitHub, con licencia MIT, que se instala por npm o se lanza con npx. Expone el buscador, el verificador y la consulta de teléfono como herramientas (find_email, find_emails_bulk, verify_email, find_phone y sus equivalentes para recoger el resultado), con Claude Desktop, Cursor y Windsurf documentados como clientes. Un asistente saca los datos de un contacto en mitad de una conversación, sin una sola línea de código de integración.
La extensión de Chrome: la vía sin código
Mucha de la gente que necesita estos datos no va a abrir un terminal en su vida. Para ellos lo que encaja es una Chrome extension, no una API.
La extensión de Enrow funciona desde un perfil de LinkedIn o de Sales Navigator. Con un clic, la ficha entera se vuelca en HubSpot, Salesforce o Pipedrive: nombre, email verificado, móvil, empresa y URL de LinkedIn. No es una dirección copiada y pegada en un campo, es la ficha de contacto completa. La facturación es la misma que en la API: un crédito por email verificado, 40 por móvil verificado y nada si no hay resultado.
RevOps monta el circuito; los comerciales trabajan perfiles. La misma bolsa de créditos, la misma verificación, dos formas de trabajar. Más detalle en cómo buscar emails desde LinkedIn y en el enriquecimiento de datos en HubSpot.
Lo que esta API no va a hacer por ti
No hay ninguna base de datos que puedas consultar. Pídele a Enrow «todos los CTO de Berlín en empresas de más de 200 personas» y no vuelve nada, porque no hay ninguna lista en la que buscar. El buscador necesita un nombre completo más el dominio o el nombre de la empresa. El buscador de teléfonos necesita una URL de LinkedIn.
Es una renuncia deliberada, y tiene su razón. Quien vende una base de datos la actualiza en ciclos que se miden en meses, de manera que una parte nada pequeña de lo que vende describe a gente que ya ha cambiado de puesto. Enrow busca cada dato en el momento de la petición, y por eso la precisión aguanta. Lo que pagas a cambio es que montar la lista pasa a ser cosa tuya. La montas en LinkedIn o en Sales Navigator y luego se la pasas a la API. El envío de campañas es trabajo de Emelia, La Growth Machine o lemlist.
Lo que cuesta cada contacto verificado
Como solo se factura el resultado encontrado, el precio que ves y el coste real son el mismo número. Start son 15 €/mes por 1.000 créditos, o sea 0,015 € por email válido. Pro, 75 €/mes por 10.000, 0,0075 €. Scale, 360 €/mes por 50.000, y la escala mensual sube hasta 200.000 créditos por 1.250 €/mes. Pasa ese último nivel a facturación anual y se queda en unos 0,0056 € por email, la tarifa más baja de toda la escala. Un móvil son 40 créditos, unos 0,30 € en Pro. La verificación, 0,25 créditos por comprobación, esté viva o muerta la dirección.
Compara eso con quien cobra por intento al mismo volumen mensual y con la misma base de facturación, y no precio de tarifa contra precio de tarifa. Una herramienta a 0,02 € por búsqueda lanzada, con una tasa de acierto del 30 %, te está costando 0,067 € por contacto encontrado, y eso antes de contar los que hacen bounce. Ese es el único número que merece la pena meter en una hoja de cálculo.
Sin coste por usuario, hasta 10 miembros de equipo en Pro e ilimitados en Scale, y los créditos se acumulan de un mes a otro hasta 3 veces tu plan en Pro y 6 veces en Scale. El plan gratuito son 50 créditos gratis cada mes, que se renuevan solos, sin pedirte tarjeta.
¿listo para dejar de perder el tiempo?
Conectado en minutos.
Data verificada en segundos.
FAQ
¿Una búsqueda fallida gasta crédito?
Depende del proveedor, y es lo primero que hay que mirar. Enrow, Anymail Finder y Findymail dicen los tres que sus endpoints de búsqueda solo facturan cuando hay resultado; ZeroBounce no cobra nada por una búsqueda que vuelve como desconocida. Quien factura por intento te cobra la pregunta. Con un 30 % de acierto en una lista fría B2B, ese modelo multiplica por más de tres el coste real por contacto y se come cualquier diferencia en el precio de tarifa.
¿Existe alguna API de email finder gratis?
Planes gratuitos hay. API gratis para siempre y con volumen, en general no, porque cada consulta le cuesta al proveedor trabajo SMTP real. Enrow te da 50 créditos gratis cada mes, sin tarjeta y durante el tiempo que quieras: 50 emails verificados o 200 comprobaciones, en la aplicación, la extensión de Chrome y los asistentes de IA. La API se abre con cualquier compra: un plan desde 15 €/mes o un paquete de créditos sin suscripción.
¿Cuánto debería tardar en responder una API de email finder?
Una consulta síncrona que pase de unos cinco segundos te da problemas en cualquier interfaz que use una persona. Hunter te deja ajustarlo con un parámetro max_duration de entre 3 y 20 segundos, y documenta que más duración significa más precisión. En trabajo por lotes lo que importa es el caudal, no la latencia de cada fila. Nadie publica un p95, de modo que mídelo tú con tu propio volumen.
¿Se puede usar una API de email finder en masa?
Sí, y por encima de unos cientos de filas conviene. Enrow admite hasta 5.000 contactos por lote de búsqueda de emails y 3.000 por lote de teléfonos, y devuelve los resultados por webhook o por GET. La API v2 de Hunter no expone ningún endpoint de búsqueda en masa, con lo cual allí los lotes son una función del panel. Confirma que ese endpoint existe antes de montar tu arquitectura sobre él.
¿Es seguro reintentar una consulta que se ha quedado sin respuesta?
Técnicamente sí, pero antes calcula lo que te cuesta. El POST no es idempotente según el RFC 9110, y Idempotency-Key es un borrador del IETF caducado con un soporte irregular, de modo que un reintento suele suponer un segundo cobro. Cuando solo se cobra el resultado válido, un reintento que no encuentra nada sale gratis y apretar los tiempos de espera deja de doler. Aun así, lleva tú el registro de los ids de búsqueda en curso.
¿Puedo enriquecer legalmente contactos que no he recogido yo?
En la UE esto se apoya en el artículo 6.1 f) del RGPD, el interés legítimo, junto con el deber del artículo 14 de informar a la persona de que tienes sus datos y la excepción del artículo 14.5 b) para cuando avisar supone un esfuerzo desproporcionado. La prospección B2B suele encajar, pero la evaluación te toca documentarla a ti, y mejor con un abogado que con una entrada de blog.
Pon a prueba los cuatro criterios con tu propia lista. La API de Enrow se abre con cualquier compra (un plan desde 15 €/mes o un paquete de créditos sin suscripción) y te da una clave en unos treinta segundos. Los 50 créditos gratis al mes del plan gratuito, sin tarjeta, sirven en la aplicación, la extensión de Chrome y los asistentes de IA.